算法概述
算法的定义
算法是由若⼲条指令组成的有穷序列
算法的性质
输入、输出、确定性、有限性
程序与算法的区别
程序是算法用某种程序设计语言的具体实现
程序可以不满足算法的有限性
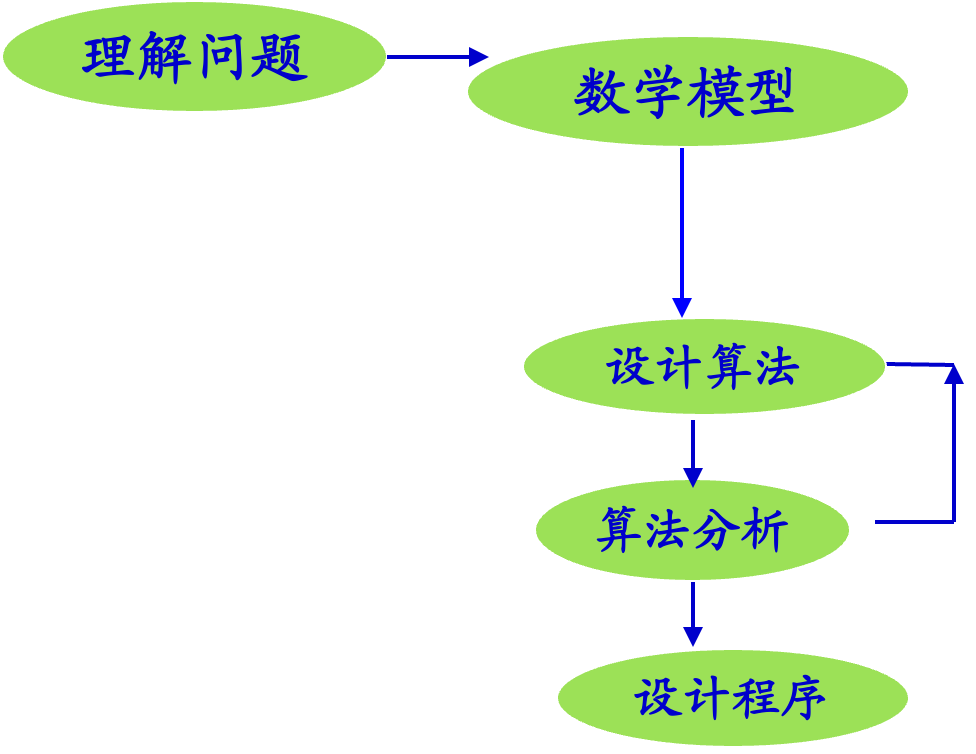
问题求解
算法复杂度
复杂性的计量
其中, 为问题规模, 为问题的输入, 为算法, 为复杂性函数, 为时间复杂度, 为空间复杂度, 为复杂性
时间复杂度
其中, 为第 条指令的执行时间(元运算时间), 为第 条指令的执行次数(元运算次数), 为算法的指令数(元运算种类)
不可能精确计算出 ,只能估计
- 最坏情况时间复杂度:,其中 为使得 最大的输入
- 最好情况时间复杂度:,其中 为使得 最小的输入
- 平均时间复杂度:,其中 为输入 出现的概率
可操作性最好且最有实际价值的是最坏情况下的复杂度
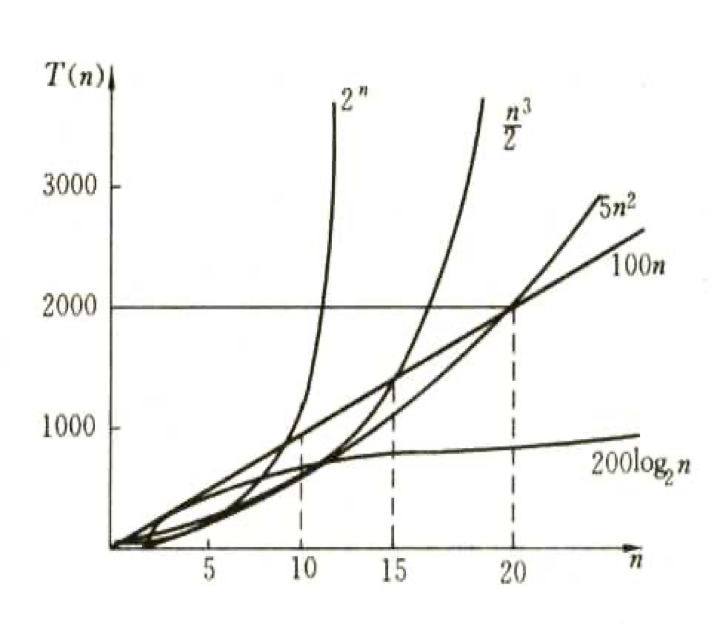
复杂性的渐进性态
渐进性态
设为算法的时间复杂度,则它是的单增函数。如果存在一个函数,使得对于,有,则称是当时的渐进性态(渐进复杂性)
渐进性态的阶
设和是定义在正整数集合上的正函数
大表示法(上限)
如果存在正常数和,使得对于一切,有,则称在时有上界,且是的一个上界,记作
上界的阶越低,则评估越精确,结果就越有价值。
- 如果,则
大表示法(下限)
如果存在正常数和,使得对于一切,有,则称在时有下界,且是的一个下界,记作
下界的阶越高,则评估越精确,结果就越有价值。
大表示法
,当且仅当且,称与同阶
NP完全性理论
P类问题
多项式时间内可解决的问题
NP类问题
多项式时间内可验证的问题,NP问题不要求给出一个算法来求解问题本身,而只要求给出一个确定性算法在多项式时间内验证它的解
递归与分治策略
递归的概念
- 递归函数:用函数自身定义的函数,两要素:边界条件与递归方程
- 递归算法:直接或间接调用自身的算法
- 双递归函数:一个函数及它的一个变量是由函数自身定义(不能转换成循环)
排列问题
设 是要进行排列的 个元素,。集合 中元素的全排列记为 。 表示在全排列 的每个排列前加上前缀 得到的排列。 的全排列可归纳定义如下:
- 当 时,,其中 是集合 中唯一的元素;
- 当 时,。
依此递归定义,可设计产生 的递归算法如下:
template <class T>
void Perm(T list[], int k, int m) { // 产生list[ ]数组中从k到m元素的全排列.
  if (k == m) {    // 只剩下一个元素
    for (int i = 0; i <= m; i++)
      cout << list[i];
    cout << endl;
  } else // 还有多个元素,递归产生排列
    for (int i = k; i <= m; i++) {
      swap(list[k], list[i]); // 固定第一个元素
      Perm(list, k + 1, m);
      swap(list[k], list[i]); // !还原,不然会有重复排列
    }
}
整数划分
将正整数 表示成一系列正整数之和,()。正整数 的这种表示称为正整数 的划分。正整数 的不同的划分个数称为正整数 的划分数,记为 。
对于数据n,最大加数n1不大于m的划分个数记作q(n, m)。
int q(int n, int m) {
  // 如果n或m小于1,没有有效的划分
  if ((n < 1) || (m < 1))
    return 0;

  // 如果n或m等于1,只有一种划分方式
  if ((n == 1) || (m == 1))
    return 1;

  // 如果n小于m,将m调整为n,避免重复计算
  if (n < m)
    return q(n, n);

  // 如果n等于m,增加一种包含m本身的划分
  if (n == m)
    return q(n, m - 1) + 1;

  // 递归计算不包含m的划分数量加上包含m的划分数量
  return q(n, m - 1) + q(n - m, m);

  // 示例说明:
  // q(6, 4) = q(6, 3) + q(2, 4)
  // q(n - m, m) 固定了6 = 4 + x中的4,只对x进行讨论
}
递归的优缺点
- 优点:
- 算法简明;
- 正确性易证明,是分析、设计的有力工具。
- 缺点:
- 执行效率不高;
- 堆栈空间耗费
分治法
分治法所能解决的问题特征
- 该问题可以分解为若干个规模较小的相同问题;
- 该问题所分解出的各个子问题是相互独立的,即子问题之间不包含公共的子问题;
- 该问题的规模缩小到一定的程度就可以容易地解决;
- 利用该问题分解出的子问题的解可以合并为该问题的解。
分治法基本思想
将规模为的问题分解为个规模较小的子问题,使这些子问题相互独立且与原问题相同,递归地解这些子问题,然后各个子问题的解合并得到原问题的解。
分治法基本步骤
Divide-and-Conquer(P):
  if |P| ≤ n₀:
    return Adhoc(P)
  divide P into P₁, P₂, ..., Pₖ
  for i from 1 to k:
    yᵢ = Divide-and-Conquer(Pᵢ)
  return Merge(y₁, y₂, ..., yₖ)
分治法求解过程
- 分解:把原问题分解为若干个规模较小、相互独立,与原问题相同的子问题;
- 求解:若子问题规模较小且容易被解决则直接解,否则再继续分解为更小的子问题,直到容易解决;
- 合并:将已求解的各个子问题的解,逐步合并为原问题的解。
分治法的时间复杂性
设为规模为的问题的解所需的时间,则有
其中, 为分解出的子问题个数, 为分解问题的规模, 为合并子问题解的时间
设,则有,则有
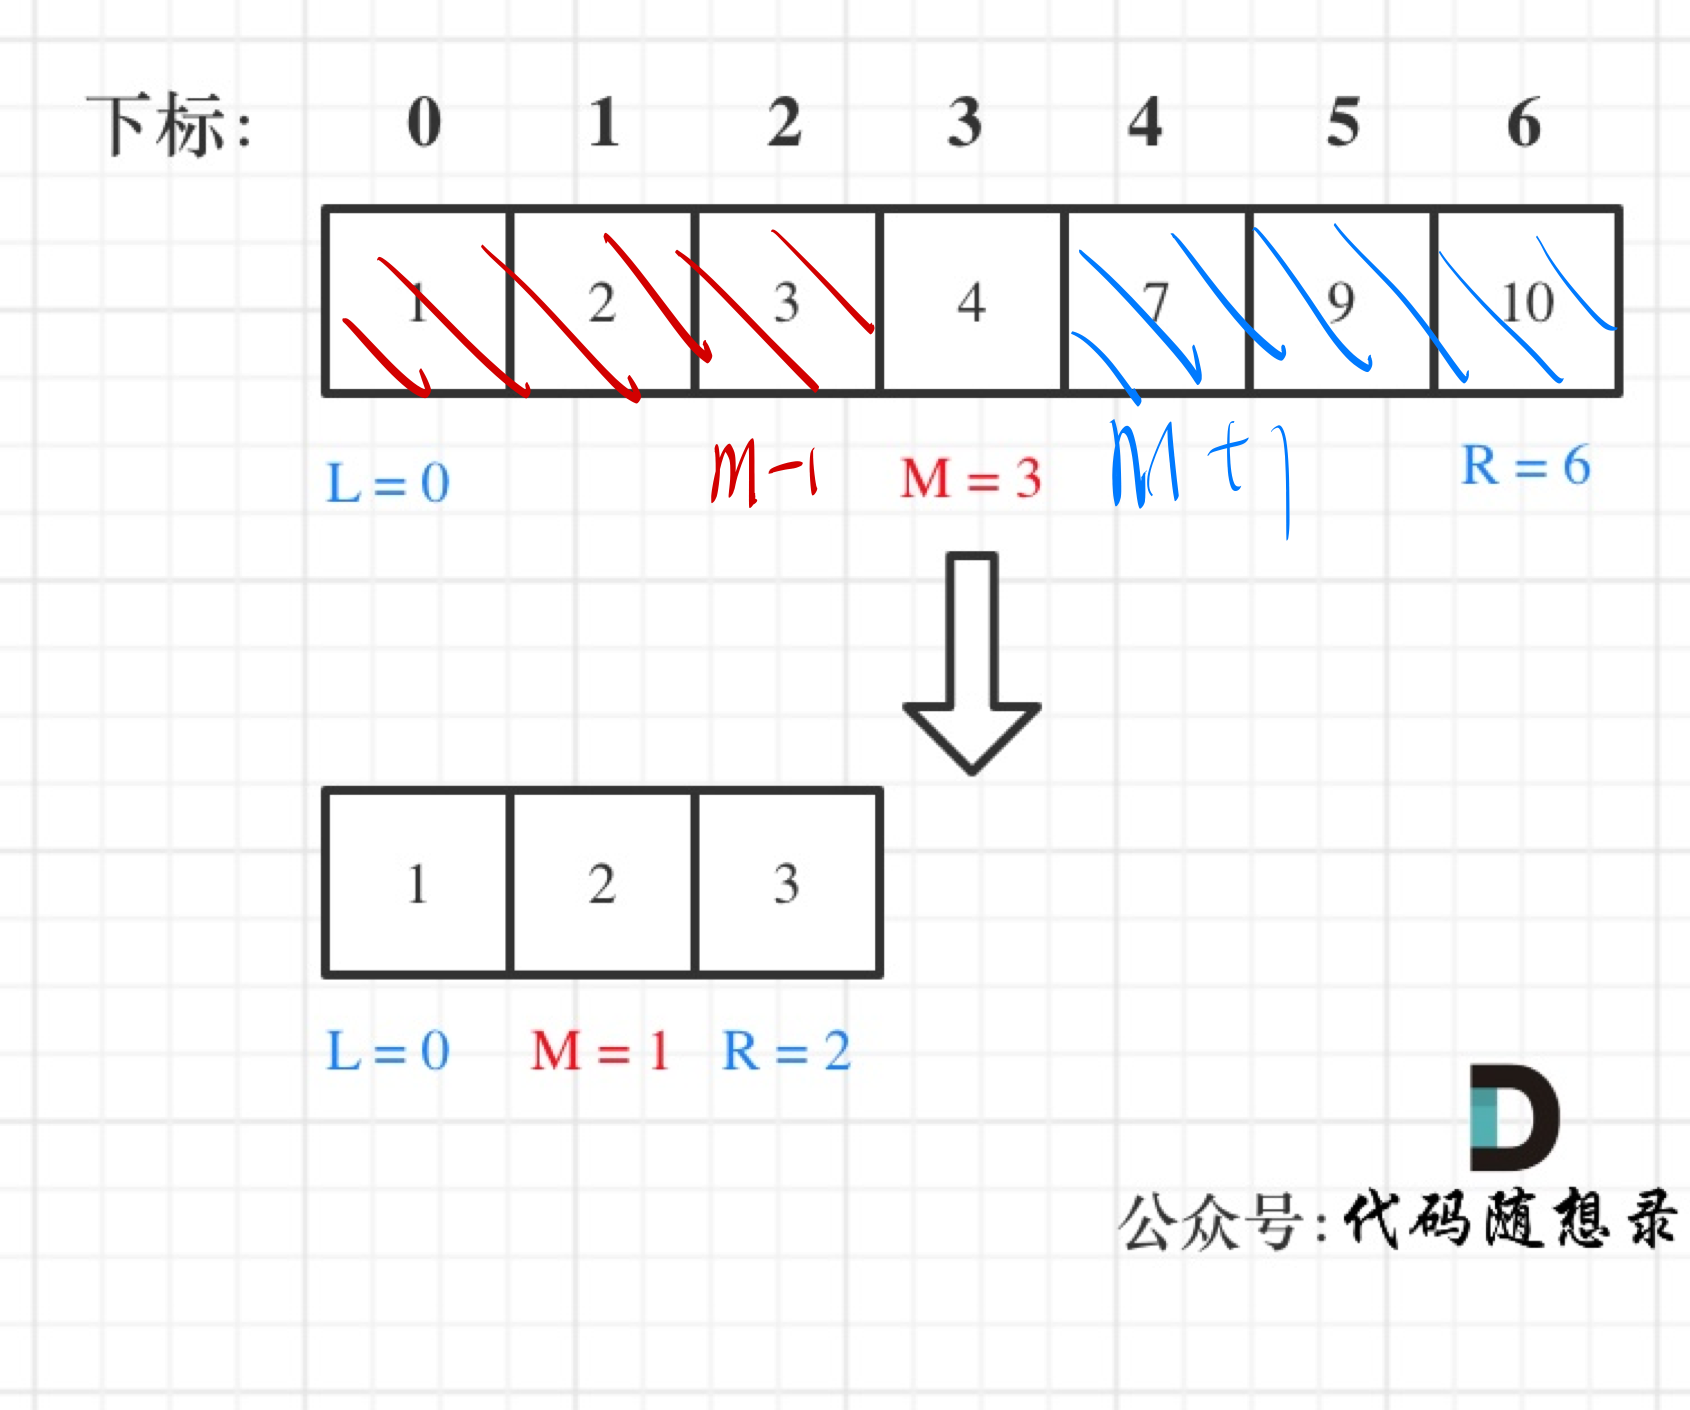
二分法
template <class T>
int BinarySearch(T a[], const T &x, int n) {
  int left = 0, right = n - 1; // 初始化左右边界
  while (left <= right) { // 当左边界小于等于右边界时继续搜索
    int middle = (left + right) / 2; // 计算中间位置
    if (x == a[middle]) // 如果找到目标值,返回其位置
      return middle;
    if (x > a[middle]) // 如果目标值大于中间值,调整左边界
      left = middle + 1;
    else // 如果目标值小于中间值,调整右边界
      right = middle - 1;
  }
  return -1; // 如果未找到目标值,返回-1
}- 递推式:
- 时间复杂度:
找金块
老板有一袋金块(共块,是2的幂()),最优秀的雇员得到其中最重的一块,最差的雇员得到其中最轻的一块。假设有一台比较重量的仪器,希望用最少的比较次数找出最重和最轻的金块
auto findMaxandMin(vector<int> &gold) {
  // 如果数组只有两个元素,直接返回最大值和最小值
  if (gold.size() == 2) {
    return gold[0] > gold[1] ? make_pair(gold[0], gold[1])
                             : make_pair(gold[1], gold[0]);
  }
  // 将数组分成左右两部分
  vector<int> left(gold.begin(), gold.begin() + gold.size() / 2);
  vector<int> right(gold.begin() + gold.size() / 2, gold.end());
  // 递归求解左右两部分的最大值和最小值
  pair<int, int> leftMaxNMin = findMaxandMin(left);
  pair<int, int> rightMaxNMin = findMaxandMin(right);
  // 返回左右两部分的最大值和最小值
  return make_pair(max(leftMaxNMin.first, rightMaxNMin.first),
                   min(leftMaxNMin.second, rightMaxNMin.second));
}
棋盘覆盖
在一个的棋盘中,有一个方格与其他方格不同,要求用L型骨牌覆盖其余方格
用分治法解决,将棋盘分为四个的子棋盘,分别覆盖,特殊方格必位于其中一个子棋盘中,其余三个子棋盘的特殊方格用L型骨牌覆盖
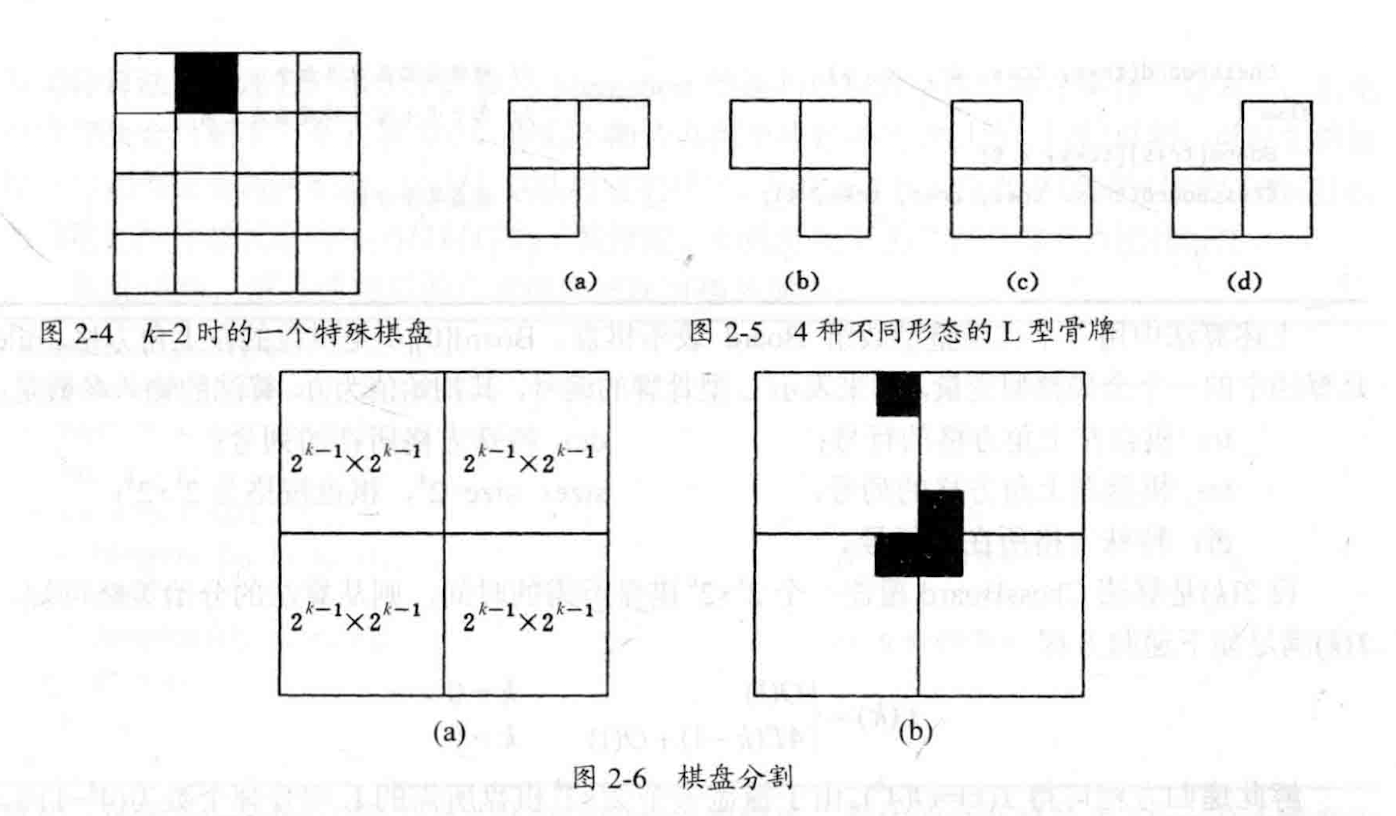
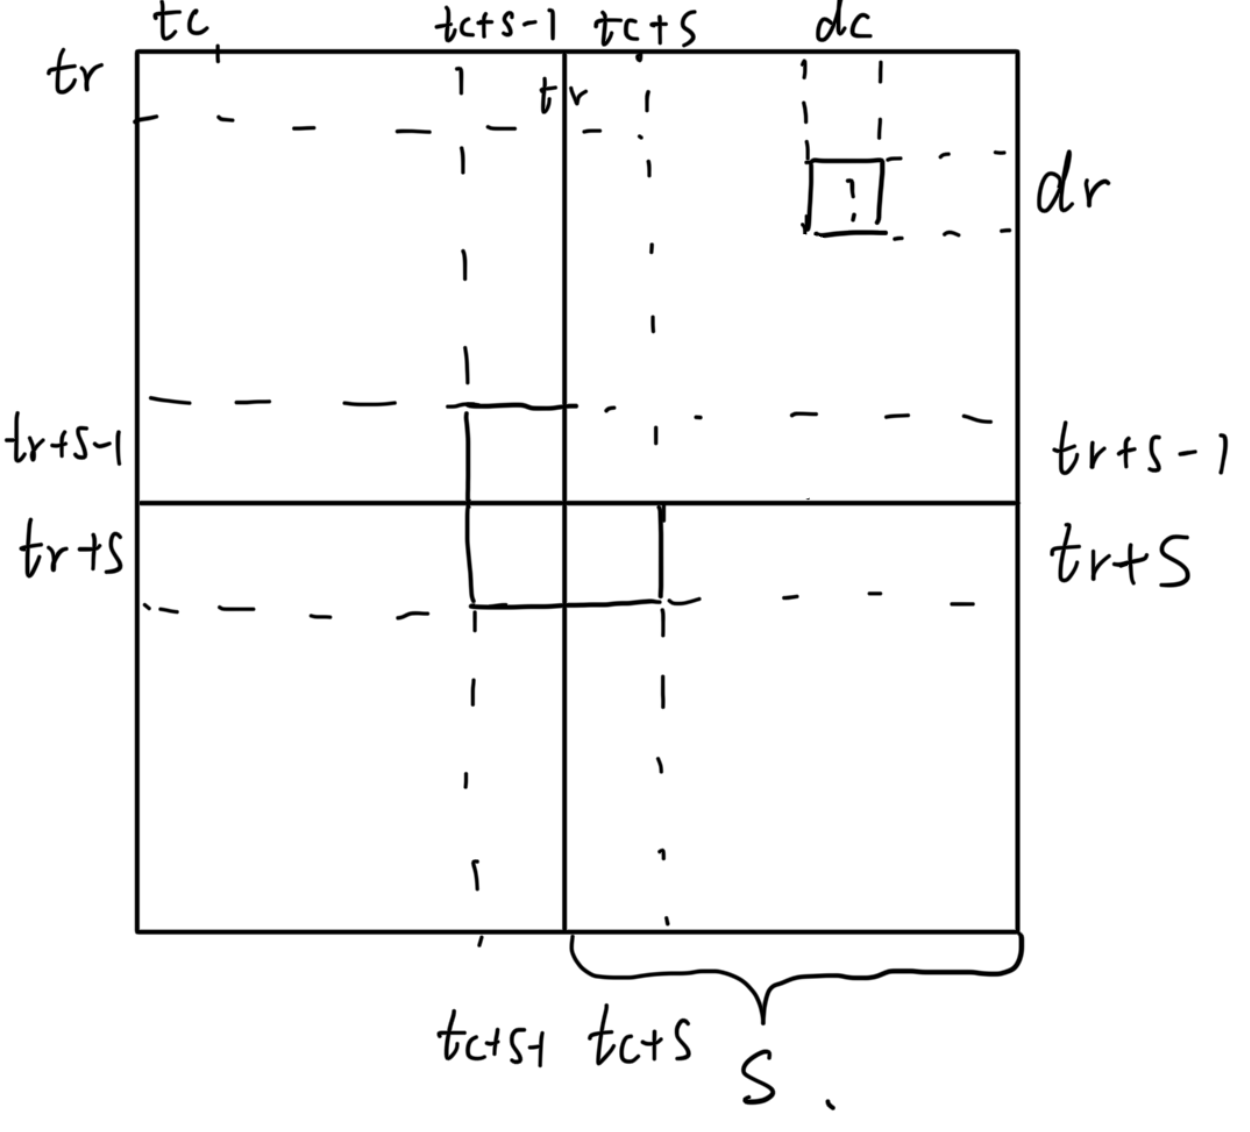
/**
  * @brief 棋盘覆盖
  * @param tr 棋盘左上角行号
  * @param tc 棋盘左上角列号
  * @param dr 特殊方格行号
  * @param dc 特殊方格列号
  * @param size 棋盘大小
  */
void ChessBoard(int tr, int tc, int dr, int dc, int size) {
  if (size == 1) return; // 基本情况:棋盘大小为1时,直接返回
  int t = tile++, s = size / 2; // t表示当前L型骨牌编号,s表示子棋盘的大小

  // 覆盖左上角子棋盘
  if (dr < tr + s && dc < tc + s)
    ChessBoard(tr, tc, dr, dc, s); // 特殊方格在左上角子棋盘
  else {
    board[tr + s - 1][tc + s - 1] = t; // 用L型骨牌覆盖右下角
    ChessBoard(tr, tc, tr + s - 1, tc + s - 1, s); // 递归处理左上角子棋盘
  }

  // 覆盖右上角子棋盘
  if (dr < tr + s && dc >= tc + s)
    ChessBoard(tr, tc + s, dr, dc, s); // 特殊方格在右上角子棋盘
  else {
    board[tr + s - 1][tc + s] = t; // 用L型骨牌覆盖左下角
    ChessBoard(tr, tc + s, tr + s - 1, tc + s, s); // 递归处理右上角子棋盘
  }

  // 覆盖左下角子棋盘
  if (dr >= tr + s && dc < tc + s)
    ChessBoard(tr + s, tc, dr, dc, s); // 特殊方格在左下角子棋盘
  else {
    board[tr + s][tc + s - 1] = t; // 用L型骨牌覆盖右上角
    ChessBoard(tr + s, tc, tr + s, tc + s - 1, s); // 递归处理左下角子棋盘
  }

  // 覆盖右下角子棋盘
  if (dr >= tr + s && dc >= tc + s)
    ChessBoard(tr + s, tc + s, dr, dc, s); // 特殊方格在右下角子棋盘
  else {
    board[tr + s][tc + s] = t; // 用L型骨牌覆盖左上角
    ChessBoard(tr + s, tc + s, tr + s, tc + s, s); // 递归处理右下角子棋盘
  }
}
大整数的乘法
将位二进制整数和都分为两段,每段的长为。
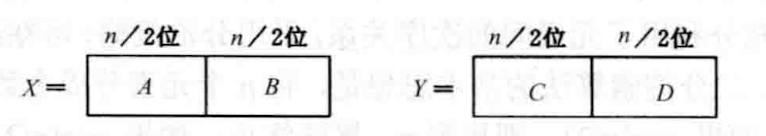
时间复杂度为:
改进:
时间复杂度:
auto Karatsuba(const string &X, const string &Y) {
  if (X.size() == 1) {
    return to_string(stoi(X) * stoi(Y));
  }
  string A = X.substr(0, X.size() / 2);
  string B = X.substr(X.size() / 2);
  string C = Y.substr(0, Y.size() / 2);
  string D = Y.substr(Y.size() / 2);
  string AC = Karatsuba(A, C);
  string BD = Karatsuba(B, D);
  string AD_BC = to_string((stoi(A) + stoi(B)) * (stoi(C) + stoi(D)) - stoi(AC) - stoi(BD));
  return to_string(stoi(AC) * pow(10, X.size()) + stoi(AD_BC) * pow(10, X.size() / 2) + stoi(BD));
}
Strassen矩阵乘法
将两个的矩阵分为四个的子矩阵, 可将方程分解为
时间复杂度:
改进:将矩阵分解为七个的子矩阵,可将时间复杂度降为
可得:
时间复杂度:
合并排序
将一个数组分为两个规模相等的子数组,分别排序,然后将两个有序子数组合并为一个有序数组
void mergeSort(std::vector<int>& arr) {
    if (arr.size() <= 1)
        return;

    size_t mid = arr.size() / 2;
    std::vector<int> left(arr.begin(), arr.begin() + mid);
    std::vector<int> right(arr.begin() + mid, arr.end());

    mergeSort(left);
    mergeSort(right);

    std::merge(left.begin(), left.end(), right.begin(), right.end(), arr.begin());
}
// 一种merge实现
template <typename T>
void my_merge(const std::vector<T>& left, const std::vector<T>& right, std::vector<T>& result) {
    size_t i = 0, j = 0;
    result.reserve(left.size() + right.size());

    while(i < left.size() && j < right.size()) {
        if(left[i] <= right[j]) {
            result.push_back(left[i++]);
        }
        else {
            result.push_back(right[j++]);
        }
    }

    while(i < left.size()) {
        result.push_back(left[i++]);
    }

    while(j < right.size()) {
        result.push_back(right[j++]);
    }
}
时间复杂度:
改进:消除算法中的递归:自然归并排序
template <typename T>
void MergeSort(T a[], int n) {
  T *b = new T[n]; // 动态分配辅助数组
  int s = 1; // 初始子数组大小为1
  while (s < n) {
    MergePass(a, b, s, n); // 将数组a中的子数组合并到b中
    s += s; // 子数组大小加倍
    MergePass(b, a, s, n); // 将数组b中的子数组合并到a中
    s += s; // 子数组大小加倍
  }
  delete[] b; // 释放辅助数组
}

template <typename T>
void MergePass(T a[], T b[], int s, int n) {
  int i = 0;
  while (i <= n - 2 * s) {
    Merge(a, b, i, i + s - 1, i + 2 * s - 1); // 合并相邻的两个子数组
    i = i + 2 * s; // 移动到下一个待合并的子数组
  }
  if (i + s < n) Merge(a, b, i, i + s - 1, n - 1); // 合并最后两个子数组
  else
    for (int j = i; j < n; j++) b[j] = a[j]; // 将剩余的元素复制到b中
}

template <typename T>
void Merge(T a[], T b[], int l, int m, int n) {
  int i = l, j = m + 1, k = l;
  while (i <= m && j <= n) {
    if (a[i] <= a[j])
      b[k++] = a[i++]; // 将较小的元素复制到b中
    else
      b[k++] = a[j++]; // 将较小的元素复制到b中
  }
  while (i <= m) b[k++] = a[i++]; // 将剩余的左半部分元素复制到b中
  while (j <= n) b[k++] = a[j++]; // 将剩余的右半部分元素复制到b中
}
快速排序
选取一个基准元素,将小于基准元素的元素放在基准元素的左边,大于基准元素的元素放在基准元素的右边,然后递归地对左右两部分进行排序
template <typename T>
int partition(T a[], int p, int r) {
  int i = p, j = r + 1;
  T x = a[p]; // 基准值 x

  while (true) {
    while (a[++i] < x && i < r)
      ; // 左指针 i 向右扫描
    while (a[--j] > x)
      ; // 右指针 j 向左扫描

    if (i >= j)
      break; // 当 i >= j 时退出循环

    swap(a[i], a[j]); // 交换 a[i] 和 a[j]
  }

  a[p] = a[j]; // 基准值放到最终位置
  a[j] = x;    // j 为基准值的位置
  return j;    // 返回基准值最终位置
}

template <typename T>
void quickSort(T a[], int l, int r) {
  if (l < r) {
    int pivot = partition(a, l, r);
    quickSort(a, l, pivot - 1);
    quickSort(a, pivot + 1, r);
  }
}- 什么时候以
i > j退出循环?什么时候以i == j退出循环?{.quiz .fill}
i > j正常情况
i == j当a[i]和a[j]都等于基准值时(数组中有且只有奇数个等于基准值的元素)或数组递减
时间复杂度:
最坏情况下时间复杂度为
改进:随机化快速排序
template <typename T>
int RandomizedPartition(T a[], int l, int r) {
  int i = rand() % (r - l + 1) + l;
  swap(a[i], a[l]);
  return partition(a, l, r);
}

template <typename T>
void RandomizedQuickSort(T a[], int l, int r) {
  if (l < r) {
    int pivot = RandomizedPartition(a, l, r);
    RandomizedQuickSort(a, l, pivot - 1);
    RandomizedQuickSort(a, pivot + 1, r);
  }
}
线性时间选择
给定线性序列和整数,求中第小的元素
思路:
随机选取一个元素作为基准元素,将小于基准元素的元素放在基准元素的左边,大于基准元素的元素放在基准元素的右边,若基准元素的位置为,则返回基准元素,否则递归地在左边或右边进行查找
template <typename T>
T RandomizedSelect(T a[], int low, int high, int k) {
  if (low == high) return a[low];
  int pivot = RandomizedPartition(a, low, high);
  int i = pivot - low + 1; // 前半部分元素个数
  if (k <= i) return RandomizedSelect(a, low, pivot, k);
  else return RandomizedSelect(a, pivot + 1, high, k - i);
}
时间复杂度:
优化
选取基准点时,不是随机选取,而是选取中位数的中位数
- 将序列分为组,找出每组的中位数
- 递归地找出这些中位数的中位数,以这个中位数的中位数作为基准点
template <typename T>
T Select(T a[], int low, int high, int k) {
  if (high - low < 75) {
    sort(a + low, a + high + 1);
    return a[low + k - 1];
  }
  // 计算五元组的数量
  int numMedians = (high - low + 1 + 4) / 5;
  for (int i = 0; i < numMedians; i++) {
    // 获取五元组的起始和结束位置
    int subLow = low + i * 5;
    int subHigh = min(subLow + 4, high);
    // 对五元组进行排序
    sort(a + subLow, a + subHigh + 1);
    // 将五元组的中位数放到数组前部
    swap(a[low + i], a[subLow + (subHigh - subLow) / 2]);
  }
  // 递归调用 Select 获取中位数的中位数
  T pivot = Select(a, low, low + numMedians - 1, (numMedians + 1) / 2);
  // 按照主元 pivot 进行划分
  int idx = partition(a, low, high, pivot);
  int i = idx - low + 1;
  if (k == i)
    return a[idx];
  else if (k < i)
    return Select(a, low, idx - 1, k);
  else
    return Select(a, idx + 1, high, k - i);
}
最接近点对问题
一维最接近点对
给定一组一维坐标,求最接近的两个点
- 排序
- 分治
- 合并
template <typename T> T ClosestPair(vector<T> &S) {
  auto len = S.size();
  if (len < 2)
    return numeric_limits<T>::max(); // 返回一个最大值表示无效情况
  auto m = len / 2;
  auto S1 = vector<T>(S.begin(), S.begin() + m);
  auto S2 = vector<T>(S.begin() + m, S.end());
  auto d1 = ClosestPair(S1);
  auto d2 = ClosestPair(S2);
  auto d3 = abs(S2.front() - S1.back());
  return min({d1, d2, d3});
}
时间复杂度:
二维最接近点对
给定平面上个点,求最接近的两个点
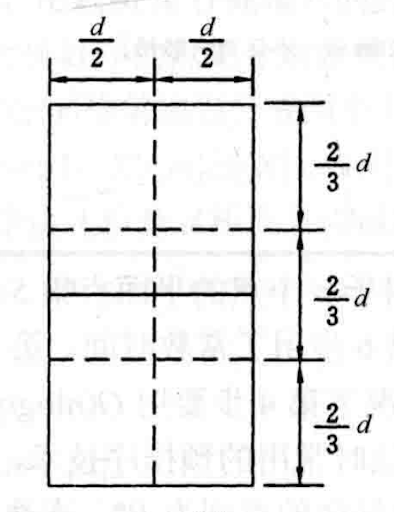
选取一垂直线(x坐标中位数)将平面分为两部分,分别求出两部分的最接近点对,
然后求出跨越垂直线的最接近点对,易证矩形中最多只有6个点
class Point {
public:
  double x, y;
  Point(double x, double y) : x(x), y(y) {}

  // 计算两个点的欧几里得距离
  auto operator-(const Point &p) const {
    return sqrt(pow(x - p.x, 2) + pow(y - p.y, 2));
  }
};

double ClosestPair2D(vector<Point> &S) {
  auto len = S.size();
  if (len < 2)
    return numeric_limits<double>::max(); // 无效情况,返回最大值

  if (len == 2)
    return S[0] - S[1];

  if (len == 3)
    return min({S[0] - S[1], S[1] - S[2], S[0] - S[2]});

  // 按x坐标排序
  sort(S.begin(), S.end(),
       [](const Point &a, const Point &b) { return a.x < b.x; });

  auto m = len / 2;
  auto S1 = vector<Point>(S.begin(), S.begin() + m); // 左半部分
  auto S2 = vector<Point>(S.begin() + m, S.end());   // 右半部分

  // 递归计算左右两部分的最小距离
  auto d1 = ClosestPair2D(S1);
  auto d2 = ClosestPair2D(S2);

  double d = min(d1, d2); // 获取左右两部分的最小距离

  // 查找分界线附近的最接近点对
  vector<Point> strip; // 存放x坐标在d范围内的点
  for (const auto &p : S) {
    if (abs(p.x - S[m].x) < d) {
      strip.push_back(p);
    }
  }

  // 按y坐标排序
  sort(strip.begin(), strip.end(),
       [](const Point &a, const Point &b) { return a.y < b.y; });

  // 查找strip中距离小于d的点对
  for (size_t i = 0; i < strip.size(); ++i) {
    for (size_t j = i + 1; j < strip.size() && (strip[j].y - strip[i].y) < d;
         ++j) {
      d = min(d, strip[i] - strip[j]);
    }
  }

  return d; // 返回最小距离
}
动态规划
动态规划的基本思想
与分治法类似,其基本思想也是将待求解问题分解成若干个子问题,先求解子问题,然后从这些子问题的解得到原问题的解。
与分治法不同的是,适合用动态规划求解的问题,经分解得到的子问题往往不是相互独立的。
动态规划的实质
动态规划的实质是分治思想和解决冗余。
- 一种将问题实例分解为更小的、相似的子问题。
- 存储子问题的解而避免计算重复的子问题。
动态规划的特点
- 动态规划法用于最优化问题,这类问题会有多种可能的解,而动态规划找出其中最优值的解。
- 对于重复出现的子问题,只在第一次遇到时加以求解,并把答案保存起来,以后再遇到时不必重新求解。
动态规划的基本步骤
- 分析最优解的性质,并刻划其结构特征;
- 递归地定义最优值;
- 以自底向上的方式计算出最优值;
- 根据递归计算最优值时得到的信息,从子问题的最优解逐步构造出整个问题的最优解
动态规划基本要素
最优子结构性质
当问题的最优解包含了其子问题的最优解时,称该问题具有最优子结构性质。
假设由最优解导出的其子问题的解不是最优的;
构造出比原问题最优解更好的解;
重叠子问题性质
每一个子问题只解一次,而后将其解保存在一个表格中,当再次需要解此子问题时,只是简单地用常数时间查看一下结果。
矩阵连乘问题
给定个矩阵,其中与是可乘的,求矩阵连乘的最优计算次序
定义为的连乘积,为计算所需的标量乘法次数
分析最优解结构
设的最优计算次序为,则有子矩阵链和的计算次序也应该是最优的。
反证法:
设的计算次序是最优的,若存在一个计算次序其需要的标量乘法次数少于,则的计算次序也应该是最优的,与假设矛盾。
可以证明矩阵连乘问题具有最优子结构性质。
建立递归关系
- 为什么是?{.quiz .fill}
因为的维数为,的维数为,的维数为,所以的维数为,所以需要次乘法
自底向上计算最优值
void MatrixChain(vector<int> &p, vector<vector<int>> &m,
                 vector<vector<int>> &s) {
  /**
    * p: 矩阵链的维数
    * m: 存储计算代价
    * s: 存储最优分割点
   */
  int n = p.size() - 1; // 矩阵链的长度
  for (int i = 1; i <= n; i++) {
    m[i][i] = 0; // 初始化对角线元素为0,因为单个矩阵的计算代价为0
  }
  for (int r = 2; r <= n; r++) { // r表示当前考虑的矩阵链的长度,从2到n
    for (int i = 1; i <= n - r + 1; i++) { // i表示矩阵链的起始位置
      int j = i + r - 1; // j表示矩阵链的结束位置
      m[i][j] = m[i + 1][j] + p[i - 1] * p[i] * p[j]; // 初始代价,假设最优分割点为i
      s[i][j] = i; // 记录最优分割点
      for (int k = i + 1; k < j; k++) { // 遍历所有可能的分割点
        int t = m[i][k] + m[k + 1][j] + p[i - 1] * p[k] * p[j]; // 计算当前分割点的代价
        if (t < m[i][j]) { // 如果当前代价小于已知最小代价
          m[i][j] = t; // 更新最小代价
          s[i][j] = k; // 更新最优分割点
        }
      }
    }
  }
}
构造最优解
void Traceback(vector<vector<int>> &s, int i, int j) {
  if (i == j) { // 如果i等于j,说明矩阵链中只有一个矩阵
    cout << "A" << i; // 输出矩阵的标识符
    return;
  }
  cout << "("; // 输出左括号表示开始一个新的矩阵链
  Traceback(s, i, s[i][j]); // 递归处理第一个子链
  Traceback(s, s[i][j] + 1, j); // 递归处理第二个子链
  cout << ")"; // 输出右括号表示结束一个矩阵链
}
最长公共子序列
子序列:一个给定序列的子序列是在该序列中删去若干元素后得到的序列。确切地说,若给定序列,则另一个序列是的子序列是指存在一个严格递增的序列,使得对于所有,有。
最长公共子序列的结构
设序列和的最长公共子序列为,则
- 若,则,且是和的最长公共子序列
- 若且,则是和的最长公共子序列
- 若且,则是和的最长公共子序列
证明:
- 如果,那么可以将加入到中,得到一个更长的公共子序列,与的定义矛盾。因此必然有。由此可知,是和的最长公共子序列。若和有长度大于的公共子序列,则将加在的末尾,得到一个长度大于的公共子序列,与的定义矛盾。
- 如果,那么是和的最长公共子序列。若和有长度大于的公共子序列,那么也是和的公共子序列,与的定义矛盾。
- 同理,是和的最长公共子序列。
子问题的递归结构
设为和的最长公共子序列的长度,则有
计算最优值
void LCSLength(const string &X, const string &Y, vector<vector<int>> &c,
               vector<vector<string>> &b) {
  int m = X.size();
  int n = Y.size();
  // for (int i = 1; i <= m; i++) {
  //   c[i][0] = 0;
  // }
  // for (int j = 0; j <= n; j++) {
  //   c[0][j] = 0;
  // }
  for (int i = 1; i <= m; i++) {
    for (int j = 1; j <= n; j++) {
      if (X[i - 1] == Y[j - 1]) { // 注意这里的下标,因为X和Y的下标是从0开始的,所以要减1
        c[i][j] = c[i - 1][j - 1] + 1;
        b[i][j] = "↖";
      } else if (c[i - 1][j] >= c[i][j - 1]) {
        c[i][j] = c[i - 1][j];
        b[i][j] = "↑";
      } else {
        c[i][j] = c[i][j - 1];
        b[i][j] = "←";
      }
    }
  }
}
构建LCS
string LCS(const string &X, const string &Y, const vector<vector<string>> &b,
           int i, int j) {
  if (i == 0 || j == 0) {
    return "";
  }
  if (b[i][j] == "↖") {
    return LCS(X, Y, b, i - 1, j - 1) + X[i - 1];
  } else if (b[i][j] == "↑") {
    return LCS(X, Y, b, i - 1, j);
  } else {
    return LCS(X, Y, b, i, j - 1);
  }
}↑和←只指引构造LCS的方向,不是LCS的一部分,只有↖才是LCS的一部分。
算法改进
省去b数组,直接构造LCS
string LCSWithoutB(const string &X, const string &Y) {
  int m = X.size();
  int n = Y.size();
  vector<vector<int>> c(m + 1, vector<int>(n + 1, 0));
  for (int i = 1; i <= m; i++) {
    for (int j = 1; j <= n; j++) {
      if (X[i - 1] == Y[j - 1]) {
        c[i][j] = c[i - 1][j - 1] + 1;
      } else {
        c[i][j] = max(c[i - 1][j], c[i][j - 1]);
      }
    }
  }
  string lcs;
  int i = m, j = n;
  while (i > 0 && j > 0) {
    if (X[i - 1] == Y[j - 1]) {
      lcs = X[i - 1] + lcs;
      i--;
      j--;
    } else if (c[i - 1][j] >= c[i][j - 1]) {
      i--;
    } else {
      j--;
    }
  }
  return lcs;
}
只计算LCS的长度,不构造LCS,仅用一维dp
int LCSLengthOnly(const string &X, const string &Y) {
  // m 保存字符串 X 的长度
  int m = X.size();
  // n 保存字符串 Y 的长度
  int n = Y.size();

  // 创建一个大小为 (n+1) 的一维数组 'c',初始值为 0。
  // 该数组用于存储到目前为止,X 和 Y 每个位置的最长公共子序列长度。
  vector<int> c(n + 1, 0);

  // 遍历字符串 X 的每一个字符
  for (int i = 1; i <= m; i++) {
    // 'prev' 保存上一次 i 循环中 c[j-1] 的值 (上一行)
    int prev = 0;

    // 遍历字符串 Y 的每一个字符
    for (int j = 1; j <= n; j++) {
      // 'temp' 临时保存当前 c[j] 的值,在它被更新前
      int temp = c[j];

      // 如果字符相同,则当前位置的 LCS 长度增加 1
      if (X[i - 1] == Y[j - 1]) {
        c[j] = prev + 1;
      } else {
        // 如果字符不同,则取当前列和前一列的最大值
        c[j] = max(c[j], c[j - 1]);
      }
      // 更新 prev 为 c[j] 原来的值
      prev = temp;
    }
  }
  // 返回最终的 LCS 长度
  return c[n];
}
最大子段和
给定由个整数组成的序列,求该序列形如的连续子段的最大和,当所有整数均为负数时,最大子段和为0。
定义dp[i]为,即以为左端点,以为右端点的最大子段和。
当dp[i-1] >= 0时,dp[i] = dp[i-1] + a[i],否则dp[i] = a[i]。
auto LSS(vector<int> a) {
  vector<int> dp(a.size() + 1);
  dp[0] = 0;
  for (int i = 1; i <= a.size(); i++) {
    dp[i] = max(dp[i - 1] + a[i - 1], a[i - 1]);
  }
  auto res = max_element(dp.begin(), dp.end());
  return *res;
}

// 状态压缩
auto LSS2(vector<int> a) {
  int dp = 0, res = 0;
  for (const auto &x: a) {
    dp = dp > 0 ? dp + x : x;
    res = max(res, dp);
  }
  return res;
}
凸多边形三角剖分
给定一个凸多边形以及定义在由多边形的边和弦组成的三角形上的权函数,将其分割成若干个三角形,使得分割后的三角形的总的权值和最小。
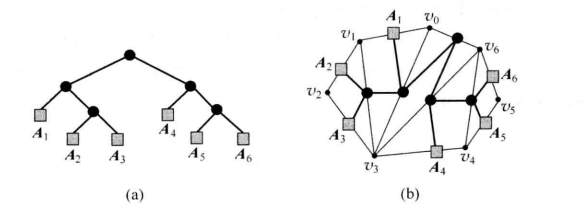
定义为凸子多边形的最优三角剖分的权值和,
void MinWeightTriangulation(vector<vector<double>> &dp, vector<vector<int>> &s) {
  int n = dp.size() - 2; // 边数 = 多边形的顶点数-1
  for (int i = 1; i <= n; i++) {
    dp[i][i] = 0;
  }
  for (int r = 2; r <= n; r++) {
    for (int i = 1; i <= n - r + 1; i++) {
      auto j = i + r - 1;
      dp[i][j] = dp[i + 1][j] + w(i - 1, i, j);
      s[i][j] = i;
      for (int k = i + 1; k < j; k++) {
        auto t = dp[i][k] + dp[k + 1][j] + w(i - 1, k, j);
        if (t < dp[i][j]) {
          dp[i][j] = t;
          s[i][j] = k;
        }
      }
    }
  }
}
图像压缩
数字化图像是的像素阵列。 假定每个像素有一个0~255的灰度值, 存储一个像素需8位。 为了减少存储空间, 采用变长模式, 即不同像素用不同位数来存储。
将像素分成连续的段,使每段中的像素存储位数相同。第段的存储像素数为l[i],且该段中的每个像素只用b[i]表示。
存储空间为,其中11m为存储段的信息所需的位数。
图像压缩的最优子结构
设是一个最优方案,显然是的最优方案,且是的最优方案。
图像压缩的递归结构
设为的最优存储位数
- 考察最后一个元素的分段情况
- 假设 自成一段,则 ;
- 假设最后 2 个像素点为一段,则 ;
- 假设最后 个像素点为一段,则 ;
- 取 为 时对应的元素个数。假设为 。
- 此时,则 ;
- 后者 ;
- 求解 即可;
- 考察最后一个像素点的分段情况,自成 1 段?后 2 个点?后 3 个点?……重复上述过程。
l[i]:前i个像素点最后一段包含的个数。b[i]:前i个像素点最后一段位数/最大值。a[i]:第i个像素点的位数。
int length(int x) {
  int l = 1;
  x >>= 1;
  while (x > 0) {
    l++;
    x >>= 1;
  }
  return l;
}

void ImageCompression(vector<int> &p, vector<int> &l, vector<int> &b,
      vector<int> &s) {
  const int n = p.size();
  constexpr int L_MAX = 256, HEADER = 11; // 定义最大块长度和头部长度
  s[0] = 0;
  vector<int> a(n, 0);
  // 计算每个像素值的位数,存储在数组 a 中
  for (int i = 0; i < n; i++) { // 遍历所有像素
    a[i] = length(p[i]); // length() 函数计算 p[i] 的二进制位数
    int bMax = numeric_limits<int>::min(); // 初始化当前块中位数的最大值
    s[i] = numeric_limits<int>::max(); // 初始化 s[i] 为最大整数
    // 考虑从位置 i 向前的不同块大小 j
    for (int j = 1; j <= i + 1 && j <= L_MAX; j++) { // j 是当前块的长度
      // 更新当前块中像素位数的最大值
      bMax = max(bMax, a[i - j + 1]); // 在当前块中找到最大的位数
      // 计算将当前块划分为长度为 j 的块后的总存储位数,并与之前的最小值比较
      if (s[i] > s[i - j] + j * bMax) {
        s[i] = s[i - j] + j * bMax; // 更新最小存储位数
        l[i] = j; // 记录当前最优块的长度
        b[i] = bMax; // 记录当前最优块的位数
      }
    }
    s[i] += HEADER; // 加上存储段信息所需的位数
  }
}
电路布线
一块电路板的上下两端分别有个引脚,用导线连接引脚和,其中是一个排列。第条连线和第条连线相交当且仅当且。要求确定导线集的最大不相交子集。
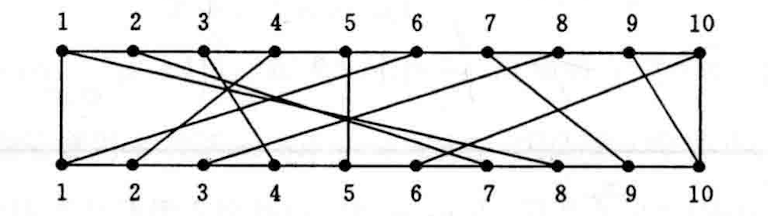
化为多步决策,自底向上,先求出只有一条连线的最大不相交子集,再求有2条连线的最大不相交子集…
电路布线的最优子结构
记,的最大不相交子集为,。
- 当时,有
- 当时,有
- 若。此时,所以,
- 若。若,则对任意,有,,否则和相交。所以是的最大不相交子集,否则是比更大的不相交子集,这与的定义矛盾。若,则对任意,有,从而,因此。另一方面,,所以,则。
递归计算最优值
- 当时,
- 当时,
// C[0:n]
void MNS(const vector<int> &C, vector<vector<int>> &size) {
  const int n = C.size();
  for (int j = 0; j < n; j++) {
    size[0][j] = j < C[0] ? 0 : 1;
  }
  for (int i = 1; i < n - 1; i++) {
    for (int j = 0; j < n; j++) {
      if (j < C[i]) {
        size[i][j] = size[i - 1][j];
      } else {
        size[i][j] = max(size[i - 1][j], size[i - 1][C[i] - 1] + 1);
      }
    }
  }
  size[n - 1][n - 1] = max(size[n - 2][n - 1], size[n - 2][C[n - 1] - 1] + 1);
}
构造最优解
auto Traceback(const vector<vector<int>> &size, const vector<int> &C) {
  vector<int> Net;
  int j = C.size() - 1;
  int m = 0;
  for (int i = C.size() - 1; i > 0; i--) {
    if (size[i][j] != size[i - 1][j]) {
      Net[m++] = i;
      j = C[i] - 1;
    }

  }if (j >= C[0]) {
      Net[m++] = 0;
    }
  return Net;
}
流水线作业调度
个作业要在2台相同的流水线上加工,每个作业加工顺序为先在上加工,再在上加工。第个作业在上加工时间为,在上加工时间为。
最优调度方案是使得没有空闲时间,的空闲时间最小。
设全部作业集合为,是一个作业子集。在一般情况下,机器开始加工中作业时,机器还在加工其他作业,要等时间后才可利用。这种情况下完成中作业所需的最短时间记为。
流水作业调度问题的最优值为。
流水线作业调度的最优子结构
设是所给个作业的一个最优调度方案,所需加工时间为。其中是在机器的等待时间为时,安排作业所需的时间。记,则。
流水线作业调度的递归计算最优值
,推广到一般情况有:
式中, 项是由于在机器上,作业i必须在时间之后才能开工。因此在机器上完成作业i之后在机器上还需要时间才能完成对作业i的加工。
流水线作业调度的Johnson法则
如果作业和作业满足,则作业应该在作业之前加工。
个任务的Johnson法则
- 令,;
- 按照的非降序排列中的任务,按照的非升序排列中的任务;
- 中的任务在中的任务之前加工。
vector<int> flowShop(const vector<int> &a, const vector<int> &b) {
  const int n = a.size();
  vector<int> C(n);
  vector<pair<int, int>> tasks(n);
  for (int i = 0; i < n; i++) {
    tasks[i] = {a[i], b[i]};
  }
  vector<int> N1, N2;
  for (int i = 0; i < n; i++) {
    if (tasks[i].first < tasks[i].second) {
      N1.push_back(i);
    } else {
      N2.push_back(i);
    }
  }
  sort(N1.begin(), N1.end(),
       [&](int i, int j) { return tasks[i].first < tasks[j].first; });
  sort(N2.begin(), N2.end(),
       [&](int i, int j) { return tasks[i].second > tasks[j].second; });
  move(N1.begin(), N1.end(), C.begin());
  move(N2.begin(), N2.end(), C.begin() + N1.size());
  return C;
}
流水线作业调度的总时间
int calculateTime(vector<int> C, const vector<int> &a, const vector<int> &b) {
    const int n = C.size();
    vector<int> f(n);
    vector<int> g(n);
    f[0] = a[C[0]];
    g[0] = f[0] + b[C[0]];
    for (int i = 1; i < n; i++) {
        f[i] = f[i - 1] + a[C[i]];
        g[i] = max(g[i - 1], f[i]) + b[C[i]];
    }
    return g[n - 1];
}
0-1背包问题
给定个物品,每个物品的重量为,价值为,背包的容量为,求如何装入背包使得背包中物品的总价值最大。
形式化描述为:给定,求一个向量,其中,使得且最大,即
0-1背包问题的最优子结构
设是一个最优解,则是下面相应子问题的一个最优解:
否则,设是上述子问题的一个最优解,则不是它的一个最优解。由此可知,,且。因此
这说明是原问题的一个最优解。从而不是原问题的一个最优解,这与假设矛盾。
0-1背包问题的递归计算最优值
设所给0-1背包的子问题的最优值为,即可选择物品为,背包容量为时的最优值。则有
// 下标从1开始
void knapsack(const vector<int> &w, const vector<int> &v, int c,
              vector<vector<int>> &m) {
  const int n = w.size();
  for (int j = 0; j <= min(c, w[n - 1]); j++) {
    m[n][j] = 0;
  }
  for (int j = w[n]; j <= c; j++) {
    m[n][j] = v[n];
  }
  for (int i = n - 1; i > 1; i--) {
    for (int j = 0; j <= min(c, w[i - 1]); j++) {
      m[i][j] = m[i + 1][j];
    }
    for (int j = w[i]; j <= c; j++) {
      m[i][j] = max(m[i + 1][j], m[i + 1][j - w[i]] + v[i]);
    }
  }
  if (c >= w[1]) {
    m[1][c] = max(m[1][c], m[2][c - w[1]] + v[1]);
  }
  else {
    m[1][c] = m[2][c];
  }
}

void Traceback(const vector<vector<int>> &m, const vector<int> &w,
               const vector<int> &v, int c, vector<int> &x) {
  const int n = w.size();
  for (int i = 1; i < n; i++) {
    if (m[i][c] == m[i + 1][c]) {
      x[i] = 0;
    } else {
      x[i] = 1;
      c -= w[i];
    }
  }
  x[n] = m[n][c] > 0 ? 1 : 0;
}
0-1背包问题的跳跃点解法
,是一个有序对的集合,其中是背包容量,是选择物品,背包容量为时的最优值。
的全部跳跃点包含于的跳跃点集与的跳跃点集的并集中
设和是中的两个跳跃点,当且时,是的一个受控点,需要删掉。
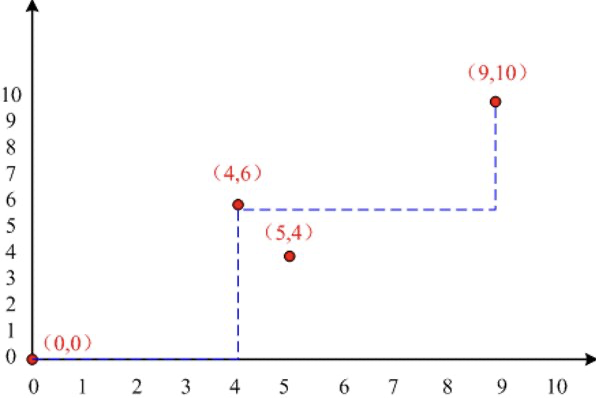
图中是的一个受控点,需要删掉。
贪心算法
活动安排问题
设有个活动的集合,每个活动都有一个使用该资源的起始时间和一个结束时间,且。如果选择活动,则活动发生在半开时间区间内。若区间与不相交,则称活动与活动是相容的。目标:找出最大相容活动集。
思路:选择最早结束的活动,然后删除与该活动相容的活动,重复此过程。
class Activity {
public:
  int id;
  int start;
  int finish;
  Activity(int s, int f) : start(s), finish(f) {
    static int count = 0;
    id = count++;
  }
};

void GreedyActivitySelector(vector<shared_ptr<Activity>> &activities,
                            vector<shared_ptr<Activity>> &selected) {

  ranges::sort(activities, [](const shared_ptr<Activity> &a,
                              const shared_ptr<Activity> &b) {
    return a->finish < b->finish;
  });
  selected.clear();
  selected.emplace_back(activities[0]);
  auto last = activities[0];
  for (int i = 1; i < activities.size(); i++) {
    if (activities[i]->start >= last->finish) {
      selected.emplace_back(activities[i]);
      last = activities[i];
    }
  }
}
证明活动安排问题的贪心选择性质
证明活动安排问题有一个最优解以贪心选择开始
设是最优解,且中活动也按非减序排列,中第一个活动是。
若,则就是一个以贪心选择开始的最优解;
否则,构造
证明每一步贪心选择→问题的整体最优解
若是的最优解,则是的最优解。
如果能找到一个的解,它包含比更多的活动,则优于,这与是最优解矛盾。
贪心算法基本要素
贪心算法通过一系列的选择来得到问题的解。它所做的每一个选择都是当前状态下局部的最好选择,即贪心选择。
- 最优子结构性质
- 贪心选择性质
贪心与动态规划的区别
- 动态规划算法通常以自底向上的方式解决问题,每步所作的选择依赖于相关子问题的解。
- 贪心算法通常以自顶向下的方式解决问题,贪心选择依赖于以往作出的选择,不依赖于子问题的解。
贪心选择思路
证明每一步贪心选择→问题的整体最优解
- 假设问题有一个整体最优解,并证明可修改这个最优解,使其以贪心选择开始。做了贪心选择后,原问题简化为规模更小的类似子问题。
- 运用数学归纳法证明:每一步贪心选择→问题的整体最优解。
背包问题(可选部分)
贪心选择性质:每次选择单位价值最高的物品。可选部分。
class Item {
public:
  int id;
  int weight;
  int value;
  double unitValue;
  Item(int w, int v) : weight(w), value(v) {
    static int count = 0;
    id = count++;
    unitValue = static_cast<double>(v) / w;
  }
};

void FractionalKnapsack(vector<shared_ptr<Item>> &items, int c,
                        vector<shared_ptr<Item>> &selected) {
  ranges::sort(items, [](const shared_ptr<Item> &a, const shared_ptr<Item> &b) {
    return a->unitValue > b->unitValue;
  });
  selected.clear();
  int weight = 0;
  for (int i = 0; i < items.size(); i++) {
    if (weight + items[i]->weight <= c) {
      selected.emplace_back(items[i]);
      weight += items[i]->weight;
    } else {
      auto remain = c - weight;
      auto item = make_shared<Item>(remain, remain * items[i]->unitValue);
      selected.emplace_back(item);
      break;
    }
  }
}
最优装载
有一批集装箱要装上一艘载重量为的轮船,其中第个集装箱的重量为。装载问题是找出尽可能多的集装箱装上轮船。
形式化描述为
贪心选择性质:每次选择重量最小的集装箱。
vector<int> Loading(vector<int> &w, int c) {
  vector<int> x(w.size());
  ranges::sort(w);
  int weight = 0;
  for (int i = 0; i < w.size(); i++) {
    if (weight + w[i] <= c) {
      x.emplace_back(w[i]);
      weight += w[i];
    }
  }
  return x;
}
哈夫曼编码
给定编码字符集,以及每个字符的频率,构造一个无歧义的前缀编码,使得所有字符的编码长度之和最小。
平均码长:,其中是字符在树中的深度。
找到使最小的前缀码编码方案。
哈夫曼编码的思路
优先队列以为关键字存放二叉树各节点,每次从中选取两个频率最小的二叉树合并,然后将新树(根节点的频率为两个子树的频率之和)插入。
class Node {
public:
  char ch;
  int freq;
  shared_ptr<Node> left;
  shared_ptr<Node> right;
  Node(char c, int f) : ch(c), freq(f) {}
};

shared_ptr<Node> Huffman(vector<pair<char, int>> &freq) {
  auto cmp = [](const shared_ptr<Node> &a, const shared_ptr<Node> &b) {
    return a->freq > b->freq;
  };
  priority_queue<shared_ptr<Node>, vector<shared_ptr<Node>>, decltype(cmp)> Q(cmp);
  for (const auto &p : freq) {
    Q.emplace(make_shared<Node>(p.first, p.second));
  }
  while (Q.size() > 1) {
    auto left = Q.top();
    Q.pop();
    auto right = Q.top();
    Q.pop();
    auto parent = make_shared<Node>('\0', left->freq + right->freq);
    parent->left = left;
    parent->right = right;
    Q.emplace(parent);
  }
  return Q.top();
}
哈夫曼编码的正确性
哈夫曼编码的贪心选择性质
设和是字符集中具有最小频率的两个字符,证明存在的最优前缀码使和具有最长、相同的码长且仅最后一位编码不同。
证明:设二叉树表示的任意一个最优前缀码方案。只要证明可以对做适当修改后,得到一棵新的二叉树,新树中,和是最深叶子且为兄弟。
同时,新树也是的最优前缀码方案。
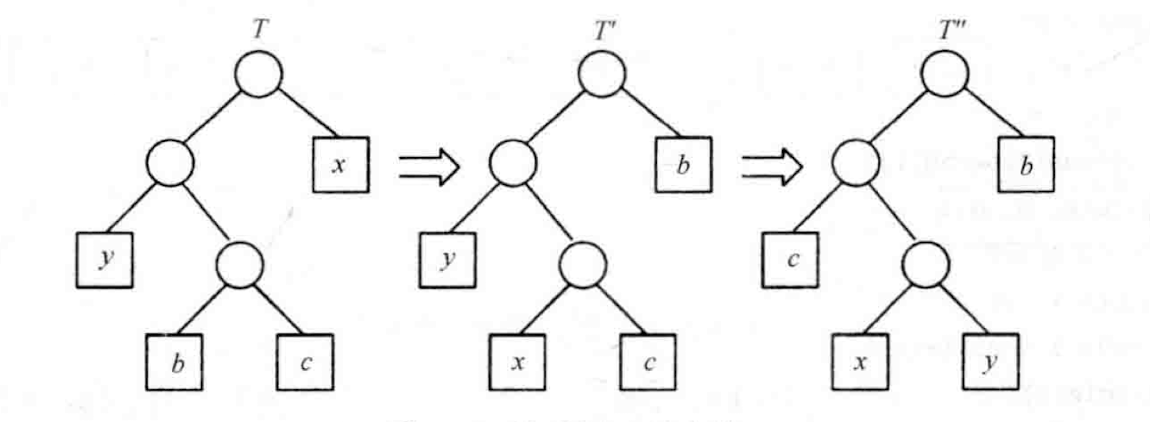
同理,,所以,又因为是最优前缀码方案,所以,所以也是最优前缀码方案。
哈夫曼编码的最优子结构性质
设表示的一个最优前缀码方案。和是树中的叶子节点且为兄弟。是它们的父亲。
若将看做是具有频率的字符,
则证明树表示字符集的一个最优前缀码即可。
证明:首先证明的平均码长可用表示。
对任意字符,有,故。
另一方面,,
故
若不是的最优前缀码方案,则存在另一棵树,使得。由于被看作中的一个字符,故在中是一个叶子节点,若将和加入树,则得到一个新树,且有
这与是最优前缀码方案矛盾,所以是的最优前缀码方案。
回溯法
问题的解空间树
解空间树是一个有根树,其每个节点对应于问题的一个解,树的根节点对应于问题的初始状态,叶节点对应于问题的一个解。
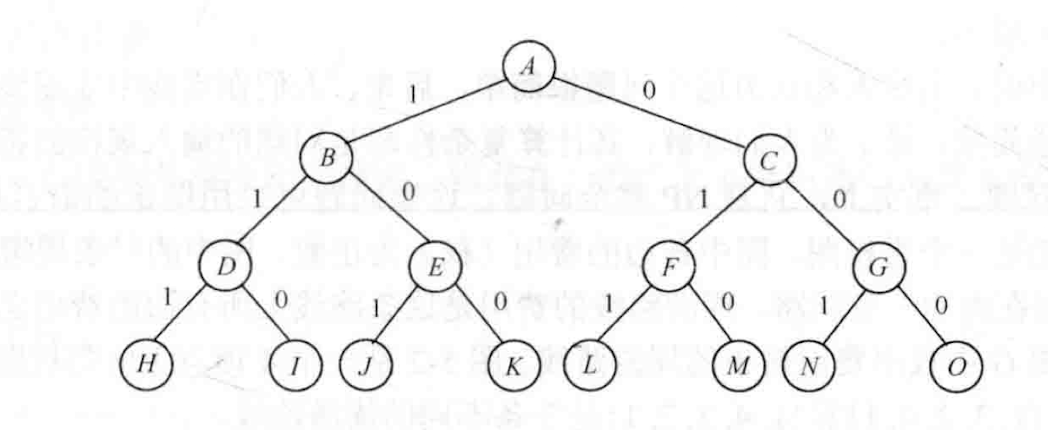
回溯法的基本思想
回溯法从根结点出发,以深度优先的方式搜索解空间树。
- [活结点]{.yellow}:自身已生成但其儿子还没有全部生成
- [扩展结点]{.green}:正在产生其儿子的结点
- [死结点]{.purple}:不满足约束条件或所有儿子已经产生的,不能向纵深方向移动的结点
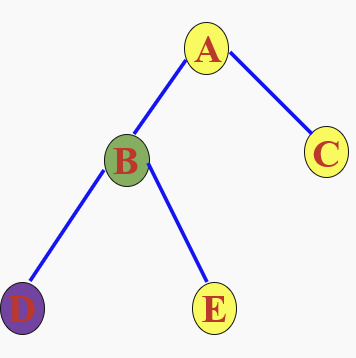
回溯法的步骤
- 针对所给问题,定义问题的解空间;
- 确定易于搜索的解空间结构;子集树,排列树
- 以深度优先方式搜索解空间,并在搜索过程中用剪枝函数避免无效搜索。
回溯法的解空间树构造
子集树
当所给问题是从个元素的集合中找出满足某种性质的子集时,解空间树是一个有根树,其每个节点对应于的一个子集。
满足所有约束条件的解状态结点称为回答结点。
排列树
当所给问题是从个元素的集合中找出满足某种性质的排列时,解空间树是一个有根树,其每个节点对应于的一个排列。
树中从根至叶结点的路径的集合构成解空间。树的每一个叶结点称为一个解状态。
解空间树的剪枝策略
- 用约束函数在扩展结点处剪去不满足约束的子树;
- 用限界函数剪去得不到最优解的子树。
回溯法的递归回溯
子集树的回溯法
// t表示当前扩展结点的深度
void Backtrack(int t) {
if (t > n) {
Output(x);
} else {
// f(n,t),g(n,t)分别表示在当前扩展结点处未搜索过的
// 子树的起始编号和终止编号
for (int i = f(n, t); i <= g(n, t); i++) {
// h(i)表示在当前扩展节点处x[t]的第i个可选值
x[t] = h(i);
// Constraint(t)和Bound(t)表示当前扩展节点处
// 的约束函数和限界函数
if (Constraint(t) && Bound(t)) {
Backtrack(t + 1);
}
}
}
}排列树的回溯法
// 调用Backtrack(1)开始搜索前,需要初始化x[1:n]为1:n
void Backtrack(int t) {
if (t > n) {
Output(x);
} else {
for (int i = t; i <= n; i++) {
swap(x[t], x[i]);
if (Constraint(t) && Bound(t)) {
Backtrack(t + 1);
}
swap(x[t], x[i]);
}
}
}回溯法的迭代回溯
void IterativeBacktrack() {
  int t = 1;
  while (t > 0) {
    if (f(n, t) <= g(n, t)) {
      for (int i = f(n, t); i <= g(n, t); i++) {
        x[t] = h(i);
        if (Constraint(t) && Bound(t)) {
          if (Solution(t)) {
            Output(x);
          } else {
            t++;
          }
        }
      }
    } else {
      t--;
    }
  }
}
旅行商问题
某旅行商要访问个城市,从城市出发,经过每个城市一次,最后回到城市。每两个城市之间有一条道路,旅行商要选择一条路径,使得总路程最短。
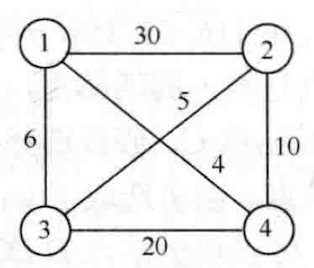
旅行商问题的解空间树
旅行商问题的解空间树是一个有根树,从根节点出发到叶节点的路径对应于旅行商的一条路径。
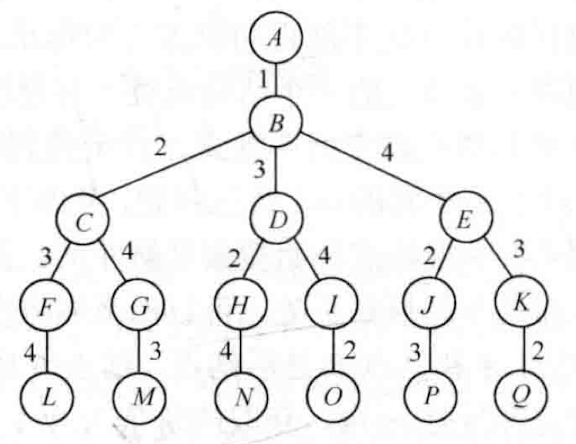
装载问题
个集装箱要装上2艘载重量分别为和的轮船,其中第个集装箱的重量为。装载问题是找出尽可能多的集装箱装上轮船。
若装载问题有解, 采用如下策略可得一个最优装载方案:
- 将第一艘轮船尽可能装满;
- 剩余的货箱装到第二艘轮船上。
将第一艘船尽可能装满等价于如下0-l背包问题:
装载问题的算法设计
template <typename T>
class Loading {
  private:
    void Backtrack(int i);
    vector<T> w; // 集装箱重量
    T c; // 轮船载重量
    T cw; // 当前载重量
    T bestw; // 当前最优载重量
  public:
    Loading() : cw(0), bestw(0) {}
    Loading(const vector<T> &ww, const T cc) : w(ww), c(cc), cw(0), bestw(0) {}
};

template <typename T>
void Loading<T>::Backtrack(int i) {
  if (i > w.size()) {
    bestw = max(bestw, cw);
    return;
  }
  // 搜索子树
  if (cw + w[i] <= c) {// 左子树(装入第i个集装箱)
    cw += w[i];
    Backtrack(i + 1);
    cw -= w[i];
  }
  // 右子树(不装入第i个集装箱)

  Backtrack(i + 1);

}

template <typename T>
T MaxLoading(const vector<T> w, const T c) {
  Loading<T> X(w, c);
  X.Backtrack(1);
  return X.bestw;
}上界函数-解决右子树剪枝问题
template <typename T>
class Loading {
  private:
    void Backtrack(int i);
    vector<T> w; // 集装箱重量
    T c; // 轮船载重量
    T cw; // 当前载重量
    T bestw; // 当前最优载重量
    T r; // 剩余集装箱重量
  public:
    Loading() : cw(0), bestw(0) {}
    Loading(const vector<T> &ww, const T cc) : w(ww), c(cc), cw(0), bestw(0) {
      r = accumulate(w.begin(), w.end(), 0);
    }
};

template <typename T>
void Loading<T>::Backtrack(int i) {
  if (i > w.size()) {
    bestw = cw;
    return;
  }
  // 计算剩余集装箱重量
  r -= w[i];
  if (cw + w[i] <= c && cw + r > bestw) {// 左子树(装入第i个集装箱)
    cw += w[i];
    Backtrack(i + 1);
    cw -= w[i];
  }
  if (cw + r > bestw) {// 右子树(不装入第i个集装箱)
    Backtrack(i + 1);
  }
  r += w[i];
}

template <typename T>
T MaxLoading(const vector<T> w, const T c) {
  Loading<T> X(w, c);
  X.Backtrack(1);
  return X.bestw;
}构造最优解-装载问题的回溯算法
template <typename T>
class Loading {
  private:
    void Backtrack(int i);
    vector<int> x; // 当前解
    vector<int> bestx; // 当前最优解
    vector<T> w; // 集装箱重量
    T c; // 轮船载重量
    T cw; // 当前载重量
    T bestw; // 当前最优载重量
    T r; // 剩余集装箱重量

  public:
    Loading() : cw(0), bestw(0) {}
    Loading(const vector<T> &ww, const T cc) : w(ww), c(cc), cw(0), bestw(0) {
      r = accumulate(w.begin(), w.end(), 0);
      x.resize(w.size() + 1);
      bestx.resize(w.size() + 1);
    }
};

template <typename T>
void Loading<T>::Backtrack(int i) {
  if (i > w.size()) {
    if (cw > bestw) {
      for (int j = 1; j <= w.size(); j++) {
        bestx[j] = x[j];
      }
      bestw = cw;
    }
    return;
  }
  r -= w[i];
  if (cw + w[i] <= c && cw + r > bestw) {
    x[i] = 1;
    cw += w[i];
    Backtrack(i + 1);
    cw -= w[i];
  }
  if (cw + r > bestw) {
    x[i] = 0;
    Backtrack(i + 1);
  }
  r += w[i];
}

template <typename T>
vector<int> MaxLoading(const vector<T> w, const T c) {
  Loading<T> X(w, c);
  X.Backtrack(1);
  return X.bestx;
}
0/1背包问题
给定个物品,每个物品的重量为,价值为,背包的容量为,求如何装入背包使得背包中物品的总价值最大。
0-1背包问题属于找最优解问题,适合于用子集树表示0-1背包问题的解空间。在搜索解空间树时
- 只要左儿子节点是一个可行结点,搜索就进入左子树。(约束剪枝)
- 在右子树中有可能包含最优解是才进入右子树搜索,否则将右子树剪去(限界剪枝)。
限界函数
设当前位于状态空间树的结点 处,已考察 个物品。
背包中的当前物品总重量为 ,背包中的当前物品总价值为 。
背包的载重量为 ,则剩余载重是 。
使用贪心法,计算以剩余载重和剩余物品构成的一般背包问题的最优解值,设该最大收益为 。
,作为以 为根的子树上所有可能的答案结点的目标函数值的上界。
0/1背包问题的回溯算法
void Backtrack(int i) {
  if (i > n) {
    bestp = cp;
  }
  if (cw + w[i] <= c) { // 左子树
    cw += w[i];
    cp += p[i];
    Backtrack(i + 1);
    cw -= w[i];
    cp -= p[i];
  }
  if (Bound(i + 1) > bestp) { // 右子树
    Backtrack(i + 1);
  }
}

int Bound(int i) {
  int cleft = c - cw;
  int b = cp;
  // 以物品单位价值递减的顺序装入物品(已经排序完成)
  while (i <= n && w[i] <= cleft) {
    cleft -= w[i];
    b += p[i];
    i++;
  }
  if (i <= n) { // 装入部分物品
    b += p[i] / w[i] * cleft;
  }
  return b;
}
最大团问题
给定无向图 ,如果 ,且对任意 ,,则称 是图 的完全子图。 的完全子图 是 的一个团当且仅当 不包含在 的更大的完全子图中。 的最大团是指 中所含顶点数最多的团。
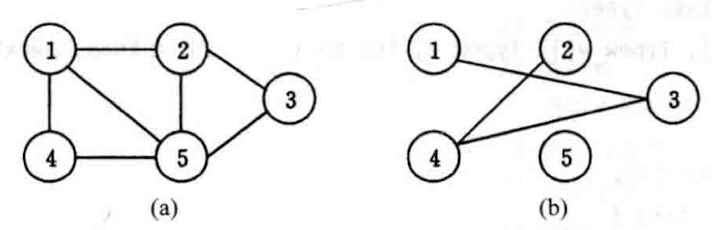
在图中的无向图 中,子集 是 的大小为 2 的完全子图。这个完全子图不是团,因为它被 的更大的完全子图 包含。 是 的最大团。 和 也是 的最大团。
如果 ,且对任意 ,,则称 是图 的空子图。 的空子图 是 的一个独立集当且仅当 不包含在 的更大的空子图中。 的最大独立集是指 中所含顶点数最多的独立集。
对于任意无向图 ,其补图 定义为 ,。 的最大独立集是 的最大团。
最大团问题的算法设计
可以用子集树表示问题的解空间。解最大团问题的回溯法与解装载问题的回溯法十分相似。设当前扩展结点Z位于解空间树的第i层。在进入左子树前,必须确认从顶点i到已选入的顶点集中每个顶点都有边相连。在进入右子树前,必须确认还有足够多的可选择顶点,使得算法有可能在右子树中找到更大的团。
整型数组v返回所找到的最大团。v[i]=1当且仅当顶点i属于找到的最大团。
class Clique {
  private:
    vector<vector<int>> a; // 图的邻接矩阵
    vector<int> x; // 当前解
    int cn; // 当前团的顶点数
    int bestn; // 当前最优团的顶点数
    int n; // 图的顶点数
  public:
    void Backtrack(int i);
    Clique() : cn(0), bestn(0) {}
    Clique(const vector<vector<int>> &aa) : a(aa), n(aa.size()) {
      x.resize(n + 1);
      bestx.resize(n + 1);
    }
    vector<int> bestx; // 当前最优解
};

void Clique::Backtrack(int i) {
  if (i > n) {
    for (int j = 1; j <= n; j++) {
      bestx[j] = x[j];
    }
    bestn = cn;
    return;
  }
  bool ok = true;
  for (int j = 1; j < i; j++) {
    if (x[j] && !a[i][j]) {
      ok = false;
      break;
    }
  }
  if (ok) {
    x[i] = 1;
    cn++;
    Backtrack(i + 1);
    x[i] = 0;
    cn--;
  }
  if (cn + n - i > bestn) {
    x[i] = 0;
    Backtrack(i + 1);
  }
}

vector<int> MaxClique(const vector<vector<int>> &a) {
  Clique X(a);
  X.Backtrack(1);
  return X.bestx;
}
图的着色
给定无向连通图 和 种不同的颜色。用这些颜色为图 的各顶点着色,每个顶点着一种颜色。是否有一种着色法,使 中每条边的 个顶点着有不同颜色?这个问题是图的 可着色判定问题。若一个图最少需要 种颜色才能使图中每条边连接的 个顶点着不同颜色,则称这个数 为该图的色数。求一个图的色数 的问题称为图的 可着色优化问题。
如果一个图的所有顶点和边都能用某种方式画在平面上且没有任何两边相交,则称这个图是可平面图。著名的平面图的四色猜想是图的 可着色性判定问题的特殊情形。
图的着色问题的算法设计
采用 -元组 表示图 的 -着色判定问题的解,并采用邻接矩阵表示无向图 。
- 显式约束:-元组 ,,,表示结点 的颜色。 表示没有可用的颜色。因此解空间的大小为 。
- 隐式约束:如果边 ,则 。
约束函数:对所有和,,,若,则。()
限界函数:对于当前解,如果已经着色的顶点数为,则剩余未着色的顶点数为,则最多需要种颜色。如果,则当前解是可行解,否则当前解是一个可行解的上界。
class Color {
private:
    bool Ok(int k);
    vector<vector<int>> a; // 图的邻接矩阵
    vector<int> x; // 当前解
    int n; // 图的顶点数
    int m; // 颜色数
    long long sum; // 当前已找到的可m着色方案数
public:
    void Backtrack(int i);
    Color() : sum(0) {}
    Color(vector<vector<int>> &&aa, int mm) : a(aa), m(mm), n(aa.size()), sum(0) { x.resize(n); }
    long long GetSum() { return sum; }
};

bool Color::Ok(int k) {
    for (int i = 0; i < k; i++) {
        if (a[k][i] && x[i] == x[k]) {
            return false;
        }
    }
    return true;
}

void Color::Backtrack(int i) {
    if (i > n) {
        sum++;
        for (int j = 0; j < n; j++) {
            cout << x[j] << " ";
        }
        cout << endl;
    } else {
        for (int j = 1; j <= m; j++) {
            x[i] = j;
            if (Ok(i)) {
                Backtrack(i + 1);
            }
            //x[i] = 0;
        }
    }
}

int mColoring(vector<vector<int>> &&a, int m) {
    Color X(std::move(a), m);
    X.Backtrack(0);
    return X.GetSum();
}
n皇后问题
在 的棋盘上放置 个皇后,使得任意两个皇后都不在同一行、同一列或同一斜线上。求所有可能的放置方案。
- 确定问题状态:问题的状态即棋盘的布局状态。
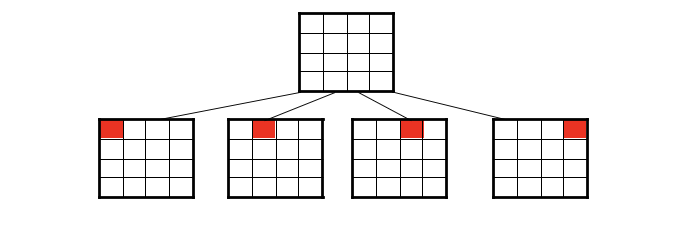
- 构造状态空间树:状态空间树的根为空棋盘,每个布局的下一步可能布局是该布局结点的子结点。
由于可以预知,在每行中有且只有一个皇后,因此可采用逐行布局的方式,即每个布局有n个子结点。
n皇后问题的算法设计
将棋盘从左至右,从上到下编号为,皇后编号为。
设解为,为皇后的列号,且位于第行。
解空间:,,
解空间为排列树。
其约束集合为
class Queen {
private:
    vector<int> x; // 当前解
    int n; // 皇后个数
    long long sum; // 当前已找到的可行方案数
    bool place(int k);
public:
    void Backtrack(int t);
    Queen() : sum(0) {}
    Queen(int nn) : n(nn), sum(0) { x.resize(n + 1); }
    long long GetSum() { return sum; }
};

bool Queen::place(int k) {
    for (int j = 1; j < k; j++) {
        if (abs(k - j) == abs(x[j] - x[k]) || x[j] == x[k]) {
            return false;
        }
    }
    return true;
}

void Queen::Backtrack(int t) {
    if (t > n) {
        sum++;
        for (int i = 1; i <= n; i++) {
            cout << x[i] << " ";
        }
        cout << endl;
    } else {
        for (int i = 1; i <= n; i++) {
            x[t] = i;
            if (place(t)) {
                Backtrack(t + 1);
            }
        }
    }
}

int nQueen(int n) {
    Queen X(n);
    X.Backtrack(1);
    return X.GetSum();
}
分支限界法
分支限界法的基本思想
分支限界法常以广度优先或以最小耗费(最大效益)优先的方式搜索问题的解空间树。
问题的解空间树是表示问题解空间的一棵有序树,常见的有子集树和排列树。在搜索问题的解空间树时,分支限界法与回溯法的主要区别在于它们对当前扩展结点所采用的扩展方式不同。在分支限界法中,每个活结点只有一次机会成为扩展结点。活结点一旦成为扩展结点,就一次性产生其所有儿子结点。在这些儿子结点中,导致不可行解或导致非最优解的儿子结点被舍弃,其余儿子结点被加入活结点表中。此后,从活结点表中取下一结点成为当前扩展结点,并重复上述结点扩展过程。这个过程一直持续到找到所需的解或活结点表为空时为止。
从活结点表中选择下一扩展结点的不同方式导致不同的分支限界法。最常见的有以下两
种方式。
队列式分支限界法
队列式分支限界法将活结点表组织成一个队列,并按队列的先进先出原则选取下一个结点为当前扩展结点。
叶子结点不能加入队列,因为叶子结点没有儿子结点。叶子结点是问题的一个解,应该直接输出。
优先队列式分支限界法
优先队列式的分支限界法将活结点表组织成一个优先队列,并按优先队列中规定的结点优先级选取优先级最高的下一个结点成为当前扩展结点。
优先队列中规定的结点优先级常用一个与该结点相关的数值p来表示。结点优先级的高低与p值的大小相关。
最大优先队列规定p值较大的结点优先级较高。在算法实现时,通常用最大堆来实现最大优先队列,用最大堆的 Deletemax 运算抽取堆中下一个结点成当前扩展结点,体现最大效益优先的原则。
类似地,最小优先队列规定p值较小的结点优先级较高。在算法实现时,通常用最小堆来实现最小优先队列,用最小堆的 Deletemin 运算抽取堆中下一个结点成为当前扩展结点,体现最小费用优先的原则。
活结点表
每个活结点只有一次机会成为扩展结点,一旦成为扩展结点,就一次性产生其所有儿子结点。在这些儿子结点中,导致不可行解或导致非最优解的儿子结点被舍弃,其余儿子结点被加入活结点表中。此后,从活结点表中取下一结点成为当前扩展结点,并重复上述结点扩展过程。这个过程一直持续到找到所需的解或活结点表为空时为止。