大数据与云计算
大数据时代
大数据定义
指规模巨大,无法在合理时间内用主流IT系统进行采集、存储、管理、处理和分析,以支持决策的海量数据集。
大数据特征 (4V+1C)
- Volume (量): 数据量巨大 (PB级常见)。
- Velocity (速): 数据产生速度快,需要快速处理。
- Variety (类): 格式多样 (结构化、半结构化、非结构化数据,如文本、音频、视频)。
- Value (值): 初始价值密度低,需要处理才能提取重要价值。
- Complexity (复杂性): 处理和分析难度大。
云计算——大数据的计算
云计算和大数据关系
- 类比: G = f(x),其中目标 (G) 通过云计算 (f) 对大数据 (x) 进行处理来实现。
- 云计算是处理大数据的手段。
- 两者相互依存:没有大数据,不需要云计算;没有云计算,无法有效处理大数据。
云计算的起源与定义
-
初始概念: 像公用事业 (水、电) 一样提供海量资源池,按需付费;从拥有资源转向共享资源 (类似公共交通 vs 私家车)
-
定义:
- 长定义: 一种商业计算模型,将任务分布在资源池上,提供按需的计算、存储和信息服务。
- 短定义: 通过网络提供按需、动态可扩展、廉价的计算服务。
- 通用定义: 一种分布式计算的商业模式,利用大量廉价机器构建可靠的海量资源池,通过网络按需访问。
云计算的核心概念:资源池
- “云” = 大规模的 (通常是廉价) 服务器集群。
- 资源被池化、虚拟化,并通过软件进行管理以实现可靠性和自我维护。
- 计算能力通过互联网作为商品提供。
- 用户动态按需访问资源,专注于业务逻辑。
云计算的关键特征 (7个)
- 超大规模
- 虚拟化
- 高可靠性
- 通用性
- 高可伸缩性
- 按需服务
- 极其廉价 (规模经济)
云计算的商业特征
- 是一种商业模式/产业技术,不仅仅是学术研究。
- 注重实用性和经济性。
- 整合了成熟技术:互联网、分布式计算、虚拟化、自治管理。
云计算发展现状
服务模式分层
- IaaS (基础设施即服务): 基础计算/存储/网络 (例如 Amazon EC2/S3, 阿里云 ECS)。面向系统开发者。(通用)
- PaaS (平台即服务): 应用运行环境 (例如 Google App Engine, Azure, Hadoop)。面向应用开发者。
- SaaS (软件即服务): 即用型应用程序 (例如 Salesforce CRM, Alexa Web)。面向最终用户。(专用)
部署模式
- 公有云: 对公众开放,由提供商管理。
- 私有云: 为单个组织服务,自行管理或由第三方管理。
- 混合云: 公有云和私有云的结合。
云计算实现机制
分层架构
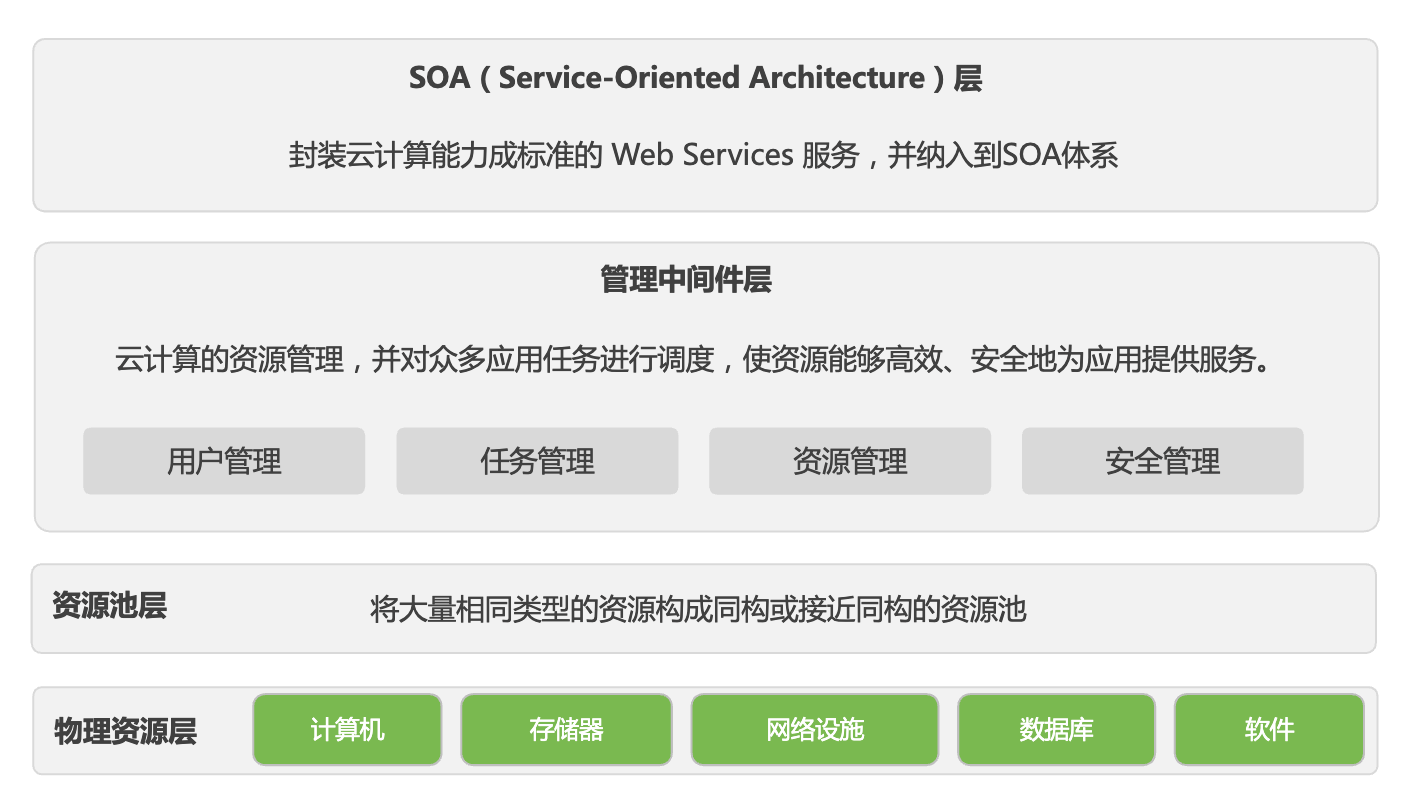
- 物理资源层: 计算机、存储、网络、数据库、软件。
- 资源池层: 对物理资源进行分组 (计算池、存储池、网络池、数据池、软件池)。
- 管理中间件层: 管理资源、任务、用户、安全。(关键组件)。包括用户/任务/资源/安全管理子模块 (负载均衡、故障处理、监控、认证/授权、计费等)。
- SOA (面向服务的架构) 层: 将能力暴露为标准的 Web 服务 (接口、注册、发现、调用、工作流)。
云计算优势
成本效益
- 解决传统 IT 成本上升问题 (管理、电力/冷却)
- 规模经济: 大型数据中心单位成本显著降低 (网络、存储、管理)
- 优化选址: 部署在电力廉价 (水电)、气候凉爽、土地成本低的地区
- 自动化: 降低人力成本
- 高利用率: 云计算利用率约 80%,而传统 IT 仅 10-15%,总成本节省超过 30 倍
用户收益
- 低规格的客户端设备即可满足需求。
- 按需付费模式使得用户能以可承受的价格获得强大的资源。
- 无需购买/维护软件或担心硬件升级。
- 节省资源,环境友好。
核心架构思想
- “团结就是力量” - 许多廉价的商用机器协同工作,提供大规模、可靠、高性能的服务 (类比:鱼群 vs 鲨鱼)。
复习题 (习题)
-
大数据是如何形成的
数据产生方式的改变;人类的活动越来越依赖数据 -
新摩尔定律 (Jim Gray 版本) 的含义
- 全球信息量呈指数增长:每18个月产生的新数据量等同于此前累积的全部数据总和
- 强调数据规模爆炸式扩大,说明对存储、计算和分析能力提出了更高要求
- 反映信息技术和社会活动对数据生成与处理的双重推动作用
-
云计算的特征
- 虚拟化:对计算、存储、网络资源进行抽象与隔离,提高利用率与灵活性。
- 按需服务:动态分配与释放资源,用户只为实际使用付费。
- 商用硬件:使用廉价大规模服务器构建资源池,降低总体成本。
- 通用性:支持多种应用场景与工作负载。
- 可靠性:通过冗余、故障检测与自动恢复保障服务可用。
- 可伸缩性:根据负载变化快速横向或纵向扩展资源。
-
云计算的分类
- 服务模型
- IaaS(基础设施即服务)
- PaaS(平台即服务)
- SaaS(软件即服务)
- 部署模式
- 公有云:第三方提供商面向公共的云服务。
- 私有云:组织内部或委托第三方私有部署。
- 混合云:公有云与私有云结合,兼顾灵活性与安全性。
- 服务模型
-
云计算的架构层次
- 物理层:物理服务器、存储、网络设备等硬件资源。
- 资源池层:通过虚拟化将物理资源划分为计算池、存储池、网络池等。
- 中间件层:负责资源管理、调度、监控、安全和计费等核心功能。
- 服务/SOA层:以标准化 API 或 Web 服务形式向用户暴露能力。
-
云计算相对于传统 IT 的成本优势
- 规模经济:大规模数据中心降低单位硬件和运维成本。
- 按需付费:避免闲置资源浪费,费用与使用量挂钩。
- 自动化运维:集中管理、自动部署和弹性伸缩减少人力成本。
- 高资源利用率:多租户共享提高硬件利用率,进一步降低总体投入。
分布式计算
分布式计算概述
基本概念
- 集中式计算:
- 所有数据和任务集中在一台计算机上处理。
- 该计算机负责管理和处理所有数据/任务,并提供服务给用户。
- 分布式计算:
- 利用多台计算机联合完成任务。
- 通过网络通信,按规则分配工作量和数据,协作完成处理任务。
集中式 vs 分布式对比
| 对比项 | 集中式计算 | 分布式计算 |
|---|---|---|
| 定义 | 计算资源集中一处处理管理 | 计算资源分散多处处理管理 |
| 资源分配 | 计算机集中处理管理所有资源 | 资源分散在多台计算机上管理分配 |
| 数据共享 | 数据集中存储,只能由该计算机访问共享 | 数据可分布在多台计算机上,可共享访问 |
| 处理能力 | 受单机硬件限制 | 通过任务分配给多台计算机提高处理能力 |
| 可靠性/安全性 | 单点故障/攻击影响整个系统 | 单个计算机故障/攻击,其他计算机仍可继续计算任务 |
| 成本 | 通常需大型机/高性能服务器,成本高 | 可利用廉价计算机集群,成本相对较低 |
分布式计算优点
- 高效性: 利用多机处理能力,提高效率和吞吐量。
- 可扩展性: 通过增加节点扩展计算能力。
- 容错性: 通过备份和任务处理节点实现容错和高可靠性。
- 低成本: 利用廉价计算资源降低成本。
- 数据局部性: 利用计算节点附近数据,减少传输开销。
集中式计算优点
- 简单性: 统一管理,简化计算和管理复杂性。
- 稳定性: 单计算机保证计算和管理的稳定可靠性。
- 统一性: 统一管理控制数据和任务流程规则。
- 安全性: 单计算机管理保护数据和任务安全机密性。
- 性能优化: 单计算机优化资源使用,提高效率和性能。
分布式计算应用场景
- 大规模数据处理 (搜索引擎、数据挖掘、机器学习)
- 高性能计算 (科学计算、模拟、仿真)
- 分布式存储 (分布式文件系统、分布式数据库)
- 实时数据处理 (流计算、实时推荐)
- 区块链技术 (比特币、以太坊)
分布式计算原理 (分而治之)
- 『分』: 将复杂庞大任务划分为小任务。
- 『计算』: 子任务分配到不同节点并行执行。
- 『合』: 汇总各节点结果得到最终结果。
- 难点: 任务划分、多节点通信方式。
分布式计算步骤
- 设计分布式计算模型: 决定组件如何运行、通信、管理节点。
- 分布式任务分配: 解决任务能否/如何分配到各节点。
- 编写并执行分布式程序: 使用特定框架/模型转化算法为实现,保证集群高效运行。
分布式计算的理论基础
ACID原则 (本地事务管理、内部一致性)
- 原子性 (Atomicity): 操作要么全成功,要么全失败,无中间状态。
- 一致性 (Consistency): 事务处理前后,不改变数据库原本的一致性约束。(核心目标)
- 隔离性 (Isolation): 并发事务间独立,互不干扰。 (手段: 写锁、读锁、范围锁)
- 持久性 (Duration): 事务生效后,对数据库的改变永久保存。(手段: Commit Logging)
- 困难: “写入磁盘”非原子操作。
- 手段: 原子性、隔离性、持久性
- 目标: 一致性
ACID原则缺点
- 性能开销: 锁定、日志记录影响并发处理能力。
- 扩展性: 强制一致性,难扩展到大规模分布式系统多节点。
- 难以维护: 事务失败回滚复杂,需协调多组件交互。
CAP理论 (分布式事务、外部一致性)
- 定义: 分布式系统最多同时满足以下三项中的两项:
- 一致性 (Consistency): 所有节点访问同一份最新数据副本。
- 可用性 (Availability): 每次请求都能获取非错响应 (不保证最新数据)。
- 分区容错性 (Partition tolerance): 网络分区时,系统仍能继续运行。(分布式系统必须满足)
- 起源: Eric Brewer 提出猜想 (2000),Seth Gilbert & Nancy Lynch 证明 (2002)。
CAP理论阐述
- 正常流程: N1, N2 数据一致 (V0),均可用。网络正常,分区容错性满足。
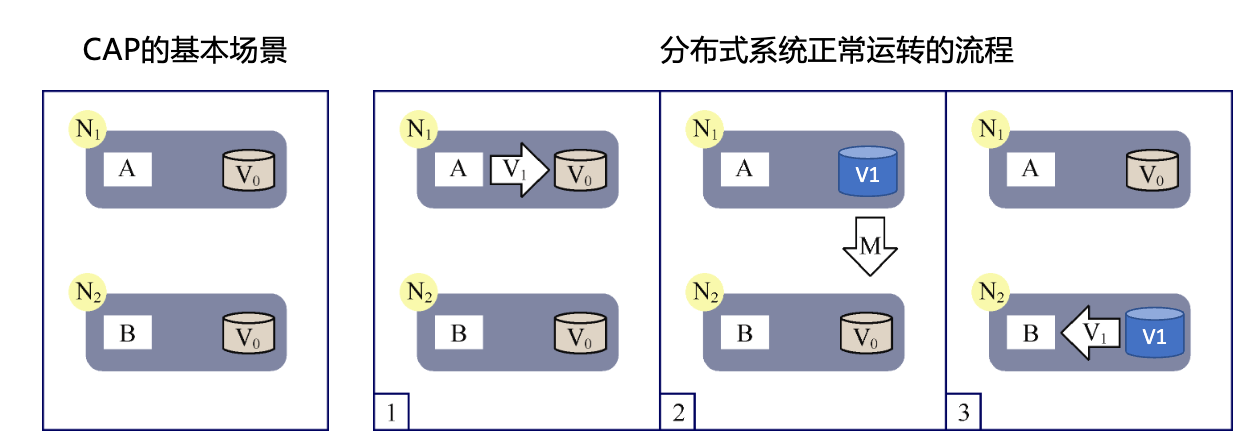
- 网络分区时: N1 与 N2 网络断开。用户向 N2 请求读数据。
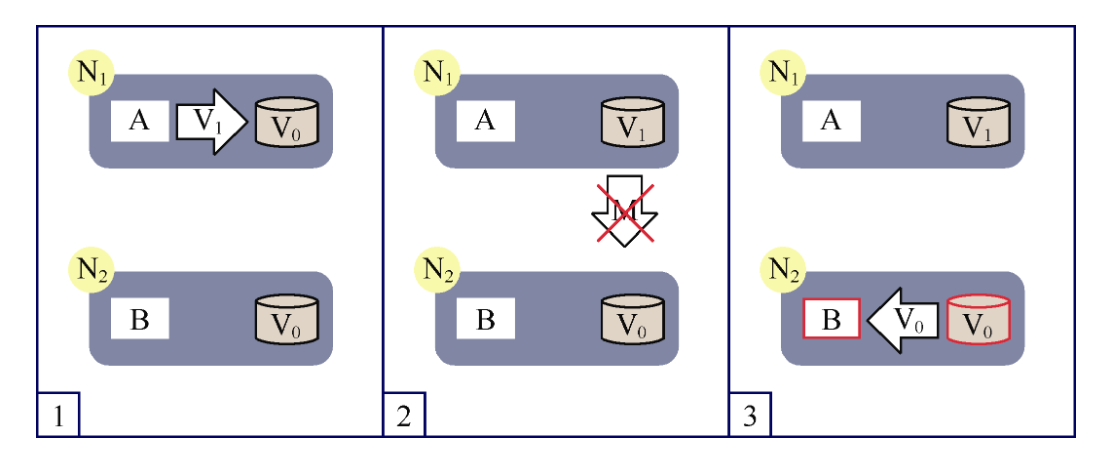
- 选择一 (牺牲一致性 C, 保留可用性 A): N2 无法同步 N1 的新数据 V1,响应旧数据 V0 给用户。(AP)
- 选择二 (牺牲可用性 A, 保留一致性 C): N2 阻塞等待,直到网络恢复、数据同步 M 完成,再响应最新数据 V1。(CP)
CAP权衡
- (1) CA w/o P: 放弃分区容错性。假设节点间通信永远可靠。不是真正的分布式系统。(例: Oracle RAC 使用共享磁盘避免网络分区)
- (2) CP w/o A: 放弃可用性。保证强一致性,分区发生时可能导致请求超时或错误。(例: HBase RegionServer 宕机期间数据不可用)
- (3) AP w/o C: 放弃(强)一致性。保证高可用,分区发生时节点用本地数据提供服务,可能导致数据不一致。(例: Redis 分区后各节点返回本地数据) (主流选择)
BASE理论
- 定义: 对 CAP 中一致性和可用性权衡的结果,核心思想是即使无法做到强一致性,但应用可采用适合方式达到最终一致性。
- Basically Available (基本可用): 系统在分区、部分节点故障时,仍能保证核心功能可用。
- Soft State (软状态): 系统状态允许在不同节点间存在中间状态,不要求实时一致。
- Eventually Consistent (最终一致性): 系统中所有数据副本经过一段时间后,最终能够达到一致状态。
- 核心思想: 牺牲强一致性换取高可用性和灵活性,适用于对一致性要求不高的场景。
BASE与ACID对比
- ACID: 传统数据库设计理念,追求强一致性模型。
- BASE: 大型分布式系统设计理念,通过牺牲强一致性获得高可用性。
一致性散列
- 问题背景: 分布式集群存储数据,如何将对象散列到不同机器?
- 简单散列:
server = hash(key) mod N(N为机器数)。 - 再散列问题 (Rehashing): 当服务器数量 N 变化 (增/减机器) 时,
hash % N结果大多会改变,导致大部分 KV 对需要迁移。
一致性散列算法 (Consistent Hashing)
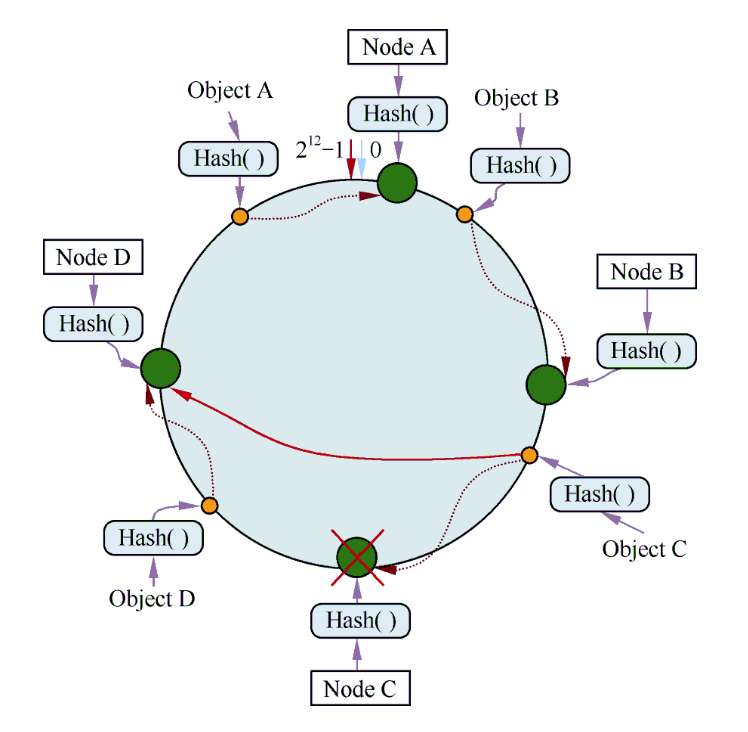
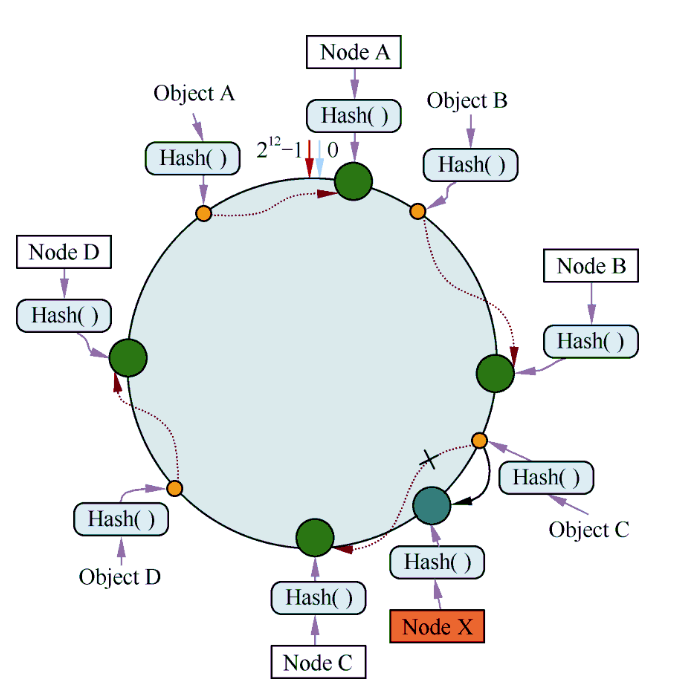
- 定义: 将整个哈希值空间 () 组织成虚拟圆环。
- 映射: 将服务器和对象 Key 都通过哈希函数映射到环上。
- 归属: 对象存储在沿环顺时针遇到的第一个服务器上。
- 应用: 高流量动态网站的分布式缓存 (Redis, MemCache) 实现请求动态均衡。
- 容错性: 节点宕机 (Node C),只影响其负责的数据 (对象 C),这些数据重定位到下一个节点 (Node D)。对象 A, B, D 不受影响。
- 扩展性: 增加节点 (Node X),只影响新节点与其前一个节点之间的数据 (对象 C 需重定位到 Node X)。对象 A, B, D 不受影响。
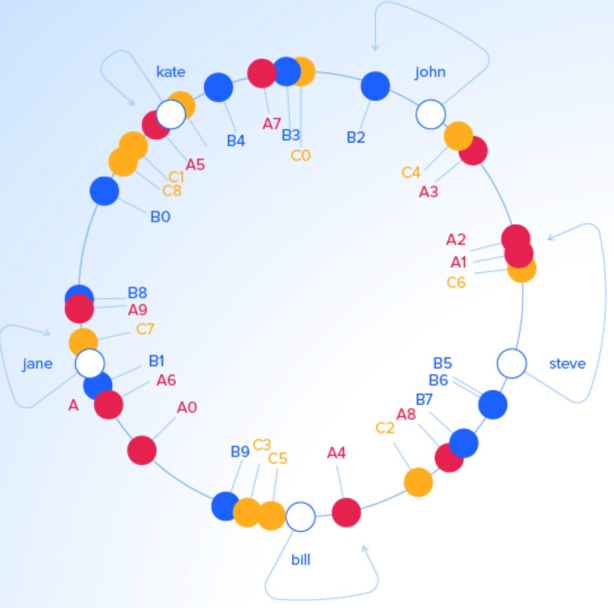
- 虚拟节点: 为解决物理节点哈希分布不均问题,将每个物理服务器映射为多个虚拟节点分散在环上,使数据分布更均匀。权重高的服务器可分配更多虚拟节点。
分布式系统概述
基础知识 (大数据驱动)
- 驱动力: 大数据技术需求推动分布式系统发展。
- 演变: 源于互联网公司大规模分布式存储系统需求。
- 扩展方式:
- 纵向扩展 (Scale Up): 传统方式,使用更强服务器 (小型机->中型机->大型机),成本高、稳定。
- 横向扩展 (Scale Out): 使用大量廉价普通服务器通过网络连接,成本低、故障率高。
- 挑战与解决:
- 故障率高 -> 软件实现自动容错、保证数据一致性。
- 增加服务器 -> 软件实现自动负载均衡,系统处理能力线性扩展。
实例:Apache Hadoop
- 定义: Apache 基金会开发的分布式存储与计算框架。
- 创始人: Doug Cutting (就职 Yahoo 期间开发,现 Cloudera)。
- 思想来源: Google 论文公开的 GFS, MapReduce, Bigtable 思想。
- 发展简史:
- 2003-2004: Doug Cutting 基于 Google 论文实现 Nutch (DFS + MapReduce 微缩版)。
- 2005 秋: Nutch 子项目引入 Apache 基金会。
- 2006.3: MapReduce 和 NDFS (后改名 HDFS) 纳入 Hadoop 项目。
- 核心组件:
- HDFS (Hadoop Distributed File System): 提供高可靠、高扩展、高吞吐率的分布式数据存储服务。
- MapReduce: 并行、分布式计算框架,易使用、高容错、高扩展。
- 云计算服务模型: Hadoop 通常属于 PaaS (平台即服务) 层,运行在 IaaS (如 AWS EC2/S3, 阿里云 ECS) 之上。
分布式系统的进阶
分布式存储系统 (5个子方向)
- 结构化存储: 关系型数据库 (MySQL)。强一致性 (银行系统),支持随机访问 (SQL, 索引)。
- 非结构化存储: 分布式文件系统 (GFS, HDFS)。存储海量数据 (网页),配合批量处理。高扩展、高吞吐。不支持随机访问,不适用低延时、实时应用。
- 半结构化存储: NoSQL, KV Store (对象存储)。解决非结构化存储随机访问性能差问题。通常抛弃 ACID 换取性能和扩展性。
- In-memory 存储: Memcached, Redis。数据存内存,读写高性能。
- NewSQL: Google Spanner。兼备 RDBMS (SQL, ACID) 和 NoSQL (扩展能力)。(目前工业界支持较少)
分布式计算系统
-
分布式计算 vs 并行计算:
- 并行计算: 目标是高性能 (投入更多机器,数据量不变,计算更快)。无内置“容错”概念。
- 分布式计算: 目标是高可扩展性 (投入更多机器,处理更大规模数据)。核心是容错。
-
分布式计算系统 (5个子方向):
- 传统基于消息的系统: MPI (Message Passing Interface)。框架灵活,约束少,不支持容错 (或有限)。(MPICH2, OpenMPI)
- MapReduce 家族系统: MapReduce, Spark。程序结构有严格约束 (Map, Reduce 等高层操作),抽象为 DAG。可扩展至超大规模集群,具备容错机制,但节点同步效率可能低。
- 图计算系统: Pregel (BSP 模型), GraphLab (GAS 模型)。专门处理图结构数据。
- 基于状态的系统: Piccolo, DistBelief, Parameter Server。适用于需要维护和同步全局状态的应用 (如大规模机器学习)。
- 实时流处理系统: Apache Storm。高效实时处理流式数据,关注实时性。在连续数据窗口内执行 SQL 类操作。
1. 传统基于消息的系统 (MPI)
- 基本思想: 程序分多个进程,进程间传递消息和数据。
- 进程位置: 可在同机不同线程、不同机器进程、甚至不同操作系统进程。
- 通信模型:
- 点对点通信: 两进程间直接通信 (发送、接收)。
- 集合通信: 多进程间数据收集与分发 (广播、聚集、散布)。
- 示例:
scatter(发散: 将根进程数据分发给各进程),gather(收集: 将各进程数据收集到根进程)。
2. MapReduce家族系统 (MapReduce, Spark)
- MapReduce:
- 批处理模型。
- 数据存储在磁盘上,适合大规模数据批处理。
- 磁盘 I/O 较多。
- Spark:
- 支持流处理和批处理两种模型。
- 采用内存计算思想,更灵活、更快。
3. 图计算系统 (Pregel/BSP & GraphLab/GAS)
- Pregel (BSP 模型 - Bulk Synchronous Parallel):
- 计算任务分若干超级步 (Supersteps)。
- 每步包含三个阶段: 计算、通信、同步。
- 所有节点完成计算和通信后,等待同步,再进入下一步。
- 同步通信模式: 本轮计算结果在下一轮生效。
- GraphLab (GAS 模型 - Gather, Apply, Scatter):
- 计算任务分三个阶段:
- Gather: 从邻居节点收集信息。
- Apply: 根据收集的信息更新自身状态。
- Scatter: 将更新后的状态信息发送给邻居节点。
- 异步通信模式: 本轮计算结果在本轮立即生效。算法收敛快,但可能存在数据不一致问题。
- 可在单机或分布式环境运行。Pregel 只能在分布式环境。
- 计算任务分三个阶段:
5. 实时流处理系统 (Storm)
- 定义: 处理实时、连续、无界数据流的系统。
- 特点:
- 简单编程模型: 类似 MapReduce 降低并行批处理复杂性,Storm 降低实时处理复杂性。
- 多种编程语言: 默认 Clojure, 支持 Java, Ruby, Python 等。
- 容错性: 管理工作进程和节点故障。
- 横向扩展: 计算在多线程、进程、服务器并行进行。
- 可靠的消息处理: 保证消息至少被完整处理一次。失败时从源头重试。
- 快速: 使用 ZeroMQ 作为底层消息队列,保证消息快速处理。
- Storm vs MapReduce/Spark (数据与计算流向):
- MapReduce/Spark: 计算传递给数据。节点存储/缓存数据集,任务提交给节点。批量处理持久化全量数据。
- Storm: 数据传递给计算。节点实现基本计算过程,数据项流经网络节点。动态处理大量生成小数据块。
分布式资源管理系统
- 需求背景:
- 多种计算框架 (MapReduce, Spark, Storm, MPI) 可能并存。
- 希望部署到公共集群,共享资源,统一管理。
- 目标: 提高资源利用率、降低运维成本、方便数据共享。
- 典型代表: Mesos, YARN。
统一管理调度平台特点
- 支持多种计算框架: 平台本身不耦合特定框架。
- 扩展性: 平台自身不应成为框架水平扩展的瓶颈。
- 容错性: 在保持原有框架容错性基础上,平台自身也应具备良好容错性。
- 高资源利用率:
- 静态资源分配 (问题): 每个框架分配固定集群,利用率低 (e.g., 10-30%)。
- 资源统一管理 (解决): 统一管理调度各种框架,提升整体资源利用率 (e.g., >70%)。
- 细粒度的资源分配:
- 粗粒度共享 (Coarse-Grained): 整个节点分配给一个框架/任务。
- 细粒度共享 (Fine-Grained): 直接按任务实际需求 (CPU, 内存) 分配资源。(Mesos 方式)
Apache Hadoop YARN (Yet Another Resource Negotiator)
- 背景: 下一代 MapReduce (MRv2),为解决 MRv1 扩展性差、不支持多计算框架问题。完全重写。
- 架构:
- ResourceManager (RM): 全局资源管理器 (Master)。负责资源分配与调度。功能简单,不易成瓶颈。
- NodeManager (NM): 节点管理器 (Slave)。负责启动/监控 Container,上报资源使用情况给 RM。
- ApplicationMaster (AM): 每个应用程序对应一个 AM。负责向 RM 申请资源,与 NM 交互启动/监控任务。(有具体应用的调度功能)
- Container: YARN 中资源分配的基本单位 (CPU, 内存等)。
Apache Mesos
- 架构:
- Mesos Master: 保存 Framework 和 Slave 状态。使用 Zookeeper 解决单点故障。全局资源调度器。
- Mesos Slave (Agent): 运行任务,向 Master 汇报状态,运行 Executor。
- Framework: 计算框架,包含 Scheduler (向 Master 注册,接收资源 offer) 和 Executor (在 Slave 上运行具体任务, e.g., Hadoop TaskTracker)。
- 资源分配流程 (两层调度):
- Agent 向 Master 汇报空闲资源。
- Master 根据策略将资源 Offer (e.g., <Agent1, 4 CPU, 4GB RAM>) 提供给某个 Framework (e.g., Framework 1)。
- Framework Scheduler 回复 Master 是否接受 Offer,并告知要在该资源上运行的任务列表及资源需求。
- Master 将任务信息发送给 Agent。
- Agent 分配资源给 Framework 的 Executor,Executor 启动任务。
Mesos与YARN比较
- 框架担任的角色:
- Mesos: 计算框架需完全融入 Mesos (部署 Scheduler 和 Executor)。添加新框架需部署。
- YARN: 框架仅是应用程序库。无需事先部署框架。YARN 运行和使用更方便。
- 调度机制 (均为双层调度):
- Mesos: 资源推送。Master 将资源 Offer 推给 Framework,由 Framework 决定是否接受及如何使用。Mesos 本身不知应用资源需求。
- YARN: 资源请求。ApplicationMaster 向 YARN (RM) 汇报任务资源需求。YARN 根据需求为应用分配资源。
课后习题
- 分布式计算的定义和特征是什么?
- 什么是 ACID 原则?
- 什么是 CAP 理论?
- 什么是 BASE 理论?
- 如何理解最终一致性?
- 各类分布式存储、分布式计算的区别与联系是什么?
课外思考
- 为什么日常生活中接触到的分布式系统越来越多了?
- CAP 定理中几个关键因素为什么不能同时保证?不同组合有什么应用场景?
- 了解区块链背景后,说说你理解的区块链作为一种分布式系统背后的全新理念。
云计算架构
云计算的本质
革命性概念:IT作为服务
- 核心思想: 云计算将所有IT资源包装成服务进行销售,类似电力公用事业(引用 Nicholas Carr《大转换》)。
- 类比:
- 蒸汽技术: 难以远程传输,本地供给。
- 发电厂: 集中生产,远程供应,形成规模效应。人们放弃自有发电机。
- 云计算: 集中化IT资源,提供新的技术和商业模式。人们可放弃自有IT资产,不必因资产由他人掌握而不安。
- 社会影响: 云计算不仅影响各行业,还引发伦理道德乃至政治问题(如数据主权、隐私、算法影响、跨境数据管理)。
- 带来的机遇/平等性:
- 低门槛发布软件触达全球用户。
- 无需高昂初始投资即可使用先进平台。
- 降低对设备和位置的依赖。
- 支持多租户。
- 依托云商架构获得高可靠性/可用性。
- 弹性伸缩应对需求波动。
- 按需增长支持企业持续发展。
云计算系统工程
- 挑战: 将大量计算资源组织在一起协同工作,需要系统性管理方法解决问题。
- 关键问题:
- 如何在扩大规模的同时保证性能近线性增长?
- 如何在组件可能故障时保证系统整体稳定运行?
- 如何快速重组资源以新架构适应不同业务需求变化?
云数据中心
- 建设考量: 需考虑持续性、能耗、安全、冷却、带宽、管理等,需自动化管理机制(故障检测定位、自动开关机)。
- 模式:
- 传统模式: 建机房、布线、放置连接机器。规模受建筑限制(如微软都柏林数据中心)。
- 基于集装箱模式: Google首创,用集装箱作机房单元(可容纳上千台服务器),可堆叠/并排形成巨大数据中心(如华为AIO集装箱数据中心)。
云的工作负载模式 (掌握)
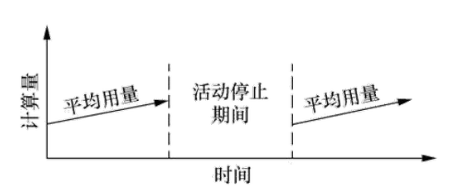
-
时开时停: 使用一段时间后停止,按用量计费,停止时释放资源。
-
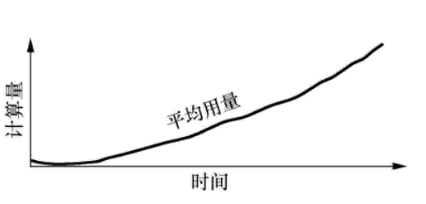
用量迅速增长: IT资源使用量随时间推移持续增长。
-
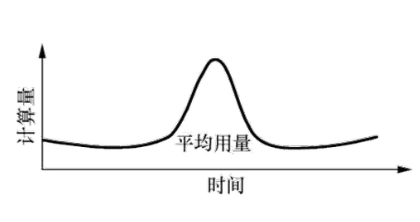
瞬时暴涨: 特定时间点用量出现暴涨和暴跌。
-
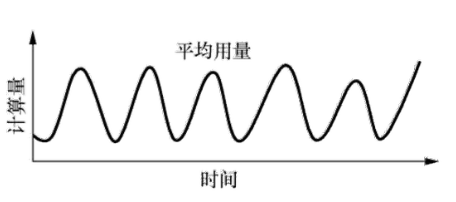
周期性增减: IT资产用量呈现周期性增长和消减。
云计算的架构
计算架构的进化
- 演进路径:
- 中央集权架构 (终端+主机)
- 客户机/服务器 (C/S) 架构
- 中间层架构 (三层架构)
- 浏览器/服务器 (B/S) 架构
- C/S 与 B/S 混合架构
- 面向服务的计算架构 (SOA):
- 程序完成自身任务,同时暴露服务供其他程序通过统一接口调用。
- 云计算将一切作为服务(软件、IT资源),是服务计算的极致体现。
一般云计算架构的二维视角
- 组成:
- 前端: 呈现给客户的部分 (客户设备、网络、访问界面如Web浏览器)。
- 后端 (云): 由各种组件构成 (服务器、存储、云管理软件等)。
- 内部结构: (见图) 硬件 -> 基础架构 -> 管理软件 (YARN, MapReduce等) -> 应用程序。强调并发、协调、容错、开放接口、数据密集、开放数据等特性。
基础架构的分层结构
- 虚拟化层 (云的基石): 将硬件转换为一致的IT资源(计算、存储),便于云管理软件细致管理(分配、动态增减)。
- Web服务层 (无状态的云服务): 将云资源通过方便界面提供给用户使用(屏蔽底层虚拟机复杂性)。
- 服务总线层/通信中间件层 (云与用户的桥梁): 封装服务,分离用户与虚拟化层,连接Web服务与用户。
- 客户机用户界面层 (将云呈现给客户): 将应用程序呈现给客户(通常是Web门户)。
REST架构:云计算的软件架构
- 基础设施四层之间采用无状态、基于服务的REST (Representational State Transfer, 表征状态转移) 架构。
- 基本思想: 面向资源来抽象问题,与面向过程的编程有本质区别。
- 核心概念:
- 资源 (Resource): 信息或数据本身 (如文章内容)。
- 表征 (Representation): 资源与用户交互时的表示形式 (如HTML, PDF)。
- 状态 (State): 特定语境下才能产生的上下文信息 (如“下一篇”依赖“当前篇”)。REST强调无状态 (Stateless),即状态由客户端维护并在请求时告知服务端。
- 转移 (Transfer): 服务端执行的、改变状态的动作 (如从“当前篇”转移到“下一篇”)。
云栈和云体
- 云体 (Cloud Body): 云计算的物质基础,软硬件环境资源集合(网络、服务器、存储器、交换机等通过网络连接)。
- 云栈 (Cloud Stack) / 云平台: 在云体上建造的运行环境,支持应用发布、运行、监控、调度、伸缩(如Azure, App Engine, Cloud Foundry)。
- 云计算 (Cloud Computing): 利用云体和云平台进行的计算或处理。特点是按用量计费、资源可伸缩。包括云存储、云服务、在云上运行软件/算法。
- 云 (Cloud): 云体、云栈、云计算的结合体,有时也称为云端或云环境。
云栈 (三层云栈架构 - 服务模式)
- 层次: 每一层提供一种抽象,越往上离物理现实越远,易用性越高。通过服务/功能实现抽象。
- 常见三层:
- IaaS (基础设施即服务): 提供基础计算/存储/网络资源(如EC2/S3, 阿里云ECS)。面向系统管理员/开发者。(通用)
- PaaS (平台即服务): 提供应用程序运行环境(如Google App Engine, Azure, Hadoop)。面向应用开发者。
- SaaS (软件即服务): 提供特定应用软件功能(如Salesforce CRM, Alexa Web)。面向最终用户。(专用)
云体
- 与传统操作系统的对比:
- 云环境: 计算资源可>1 CPU (多节点),独立存储,提供通信通道。虚拟化提供灵活资源 (N个CPU)。
- 传统OS: 应用使用CPU、内存/磁盘,与其他程序通信。OS提供进程/线程、内存管理、文件系统、IPC/网络等抽象,并负责控制调度。
软件定义的数据中心 (SDDC)
数据中心的历史
- 演进: 集中 -> 分散 -> 再集中。新的集中模式(云)远超大型机时代。
- 阶段: 60年代 (大型机) -> 80年代 (微型计算机) -> 90年代 (C/S推动DC发展) -> 21世纪 (IDC出现,现代DC)。
传统数据中心的问题
- 机器过多: 手动配置(OS、网络、注册、用户分配、软件)劳动密集。
- 利用率过低: 服务器利用率常低于10%,浪费资源和电力(>90%成热量)。
- 应用迁移困难: 硬件升级换代导致应用迁移复杂(重配置、兼容性问题)。
- 存储需求增长快: 存储更新关键且复杂,设备异构性(厂商、接口)导致管理困难、不兼容。
什么是软件定义数据中心 (SDDC)?
- 起源: 服务器虚拟化技术的延伸。
- 核心: 将虚拟化范围从计算扩展到存储和网络,并提供软件工具管理这些虚拟化资源。
- 定义 (IBM): SDDC 将虚拟化的计算、存储、网络资源与标准化管理平台结合,跨虚拟化层实现管理标准化,支持基于策略的自动化,简化运营,更快以服务形式交付IT资源。
SDDC 的分层模型与架构分析
- 硬件基础设施: 服务器、存储、网络设备 (最好支持硬件虚拟化)。
- 软件抽象 (虚拟化层): 硬件能力抽象为统一管理的资源池 (虚拟机、虚拟存储、虚拟网络)。
- 软件定义 (控制层): 对计算、存储、网络资源集中管理,提供权限、备份、高可用等特性 (如vCenter)。
- 服务的自动化配置 (编排层): 按预设步骤自动部署服务 (如vCAC)。
实践: OpenStack
- 定义: 云平台操作系统(分布式),统一管理多节点计算、存储、网络资源池,通过Web界面管理。
- 重要性: 市场需求大,人才缺口大。
- 目标: 提供实施简单、大规模扩展、丰富、标准统一的云计算管理平台。支持各类云环境。
- OpenStack 组件:
- Nova (计算): 核心,管理VM生命周期。
- Horizon (仪表盘): Web GUI界面。
- Keystone (身份): 认证与授权。
- Neutron (网络): SDN网络虚拟化管理。
- Cinder (块存储): 持久化块存储服务。
- Swift (对象存储): 分布式对象存储 (类S3)。
- Glance (镜像): 管理VM镜像。
- Ceilometer (监控): 资源监控与计量。
- Heat (编排): 基于模板编排复合云应用。
- 安装实践: 使用 Packstack 工具安装。步骤包括初始化配置、网络配置、主机名解析、YUM源配置、安装Packstack。
课后习题 (小结)
- 云计算中的工作负载有哪几种模式?它们的特征是什么?
- 什么是REST 设计风格?
- 如何理解“云栈”和“云体”的概念?
- 什么是软件定义的数据中心?它的特点是什么?
课外思考 (小结)
- 云计算的架构是如何演化的?
- 如何理解“软件定义一切”的说法?
动手实践 (小结)
- 任务:通过OpenStack官网了解项目情况。
- 任务:通过Packstack工具安装并体验OpenStack。
虚拟化技术
虚拟化的定义
虚拟化历史
- 起源: 20世纪50年代。
- 1959年: Christopher Strachey 提出“大型高速计算机中的时间共享”论文。
- 目的: 最初为满足分时系统需求,解决早期OS单任务问题。
- 早期应用: IBM 7044 是最早使用虚拟化技术的计算机之一,后大型机/小型机开始使用。
x86架构中的虚拟化演进
- 纯软件『全虚拟化』: 无需硬件或OS修改。
- 『半虚拟化模式』: 需修改客户机OS以提高性能。
- 『硬件虚拟化』: Intel VT/AMD-V 等技术,用硬件代替软件实现虚拟化。
虚拟化概念
- 广义: 对计算资源的抽象,不仅仅是虚拟机。
- 例: 虚拟内存技术,抽象物理内存,提供连续地址空间给应用,实际数据可分页/分段/交换到外存。
- 狭义 (通常指): 通过虚拟化技术将一台计算机虚拟为多台逻辑计算机 (虚拟机)。
- 效果: 提高硬件利用率 (一台服务器承载多台服务器负载),实现用户任务和数据隔离,增强安全性。
- 实现: 一台计算机上运行多个逻辑计算机,各自运行不同OS和应用,相互独立。
虚拟化技术主要分类 (4大类)
- 服务器虚拟化:
- 解决服务器利用率低 (<15%)、数量剧增、部署复杂问题。
- 将多操作系统作为VM运行在单台物理服务器上。
- 聚合服务器集群为整合资源池,提高效率,降低成本。
- 软件定义的存储 (SDS):
- 抽象内部磁盘/闪存为高性能存储池。
- 以软件形式交付,提高运维效率。
- 网络虚拟化:
- 以软件形式完整再现物理网络。
- 提供与物理网络相同功能/保证,并具备虚拟化运维优势和硬件独立性。
- 桌面虚拟化:
- 快速向分支机构、外包/海外/移动员工交付虚拟桌面和应用。
- 快速响应需求变化。
虚拟化与云计算
- 虚拟化技术促进了云计算概念的产生,是其主要支撑技术之一。
- 核心优势: 提高硬件利用率、实现用户任务/数据隔离、增强安全性。
服务器虚拟化
基本概念与架构
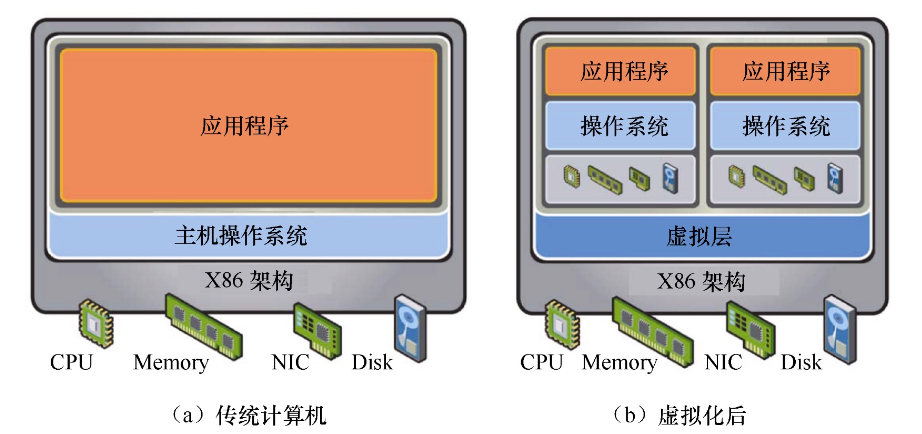
- 定义: 使用控制程序(VMM)隐藏物理平台特性,提供抽象、统一、模拟的计算环境 (虚拟机)。
- 客户操作系统 (Guest OS): 运行在虚拟机中的操作系统。
- 虚拟机监控器 (Virtual Machine Monitor, VMM / Hypervisor): 实现虚拟化的核心层。
- 主机操作系统 (Host OS): 运行 VMM 的操作系统 (仅限 Type II)。
Hypervisor 类型
- Type I (裸金属架构): VMM/Hypervisor 直接运行在硬件之上。(例: Xen, ACRN)
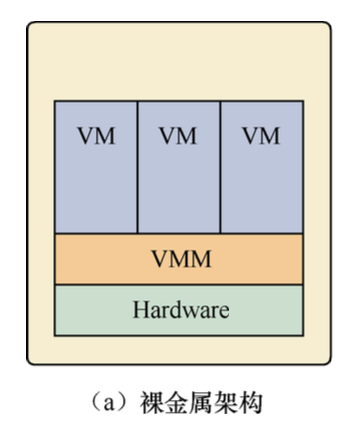
- 优点: 效率高,扩展性、健壮性、性能更好。
- Type II (寄居架构/托管架构): VMM/Hypervisor 运行在 Host OS 之上,VM 作为 Host OS 的一个进程。(例: KVM, VMware Fusion, VirtualBox, Parallels Desktop)
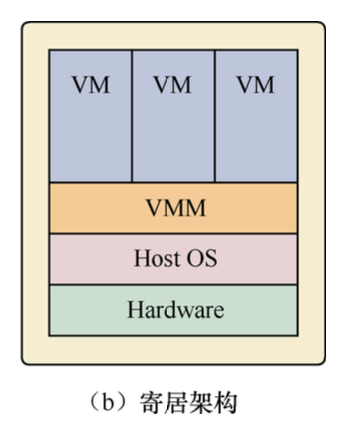
- 优点: 使用方便,与宿主 OS 兼容。桌面用户常用。
x86架构对虚拟化的限制 (Ring特权级)
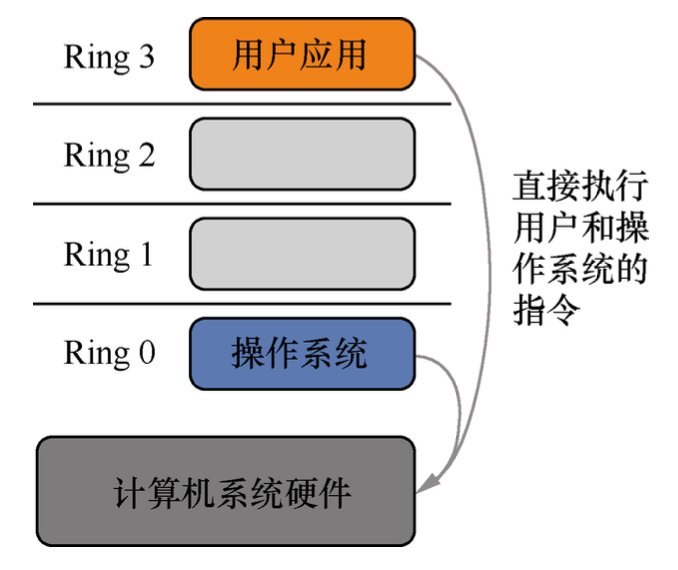
- x86 Ring: Ring 0 (最高权限, OS内核), Ring 3 (最低权限, 用户应用)。
- 特权指令: 只能在 Ring 0 执行,直接访问硬件/内存。
- 系统调用: 应用(Ring 3) -> 内核(Ring 0)切换 -> 内核代码执行 -> 返回应用(Ring 3)。(用户态/内核态切换)
- 虚拟化难题: Host OS/VMM 运行在 Ring 0。Guest OS 被置于非 Ring 0 (如 Ring 1 或 Ring 3) 运行。当 Guest OS 尝试执行特权指令时,因权限不足导致出错 (trap)。
VMM 实现 Guest OS 访问硬件的三种技术
- 全虚拟化 (Full Virtualization)
- 半虚拟化 (Paravirtualization)
- 硬件辅助虚拟化 (Hardware-Assisted Virtualization)
全虚拟化
- 核心技术 (VMware, 1998): 二进制翻译 (Binary Translation, BT)。
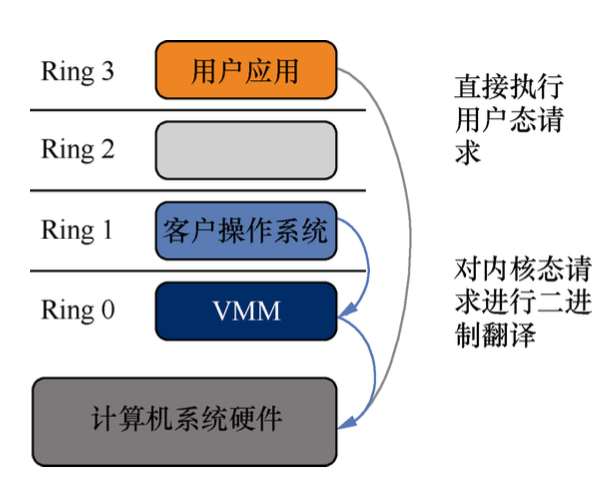
- 原理:
- VMM 捕获 Guest OS 的特权指令。
- 翻译: 将捕获的指令翻译成可在用户态运行的指令序列。
- 缓存: 翻译结果缓存,供后续使用。
- 用户级指令直接在 CPU 上运行 (速度接近物理机)。
- 特点:
- Guest OS 无需任何修改,不知道自己被虚拟化。
- VMM 与物理硬件完全解耦。
- 是唯一无需硬件辅助或OS辅助即可虚拟化敏感/特权指令的方案。
半虚拟化
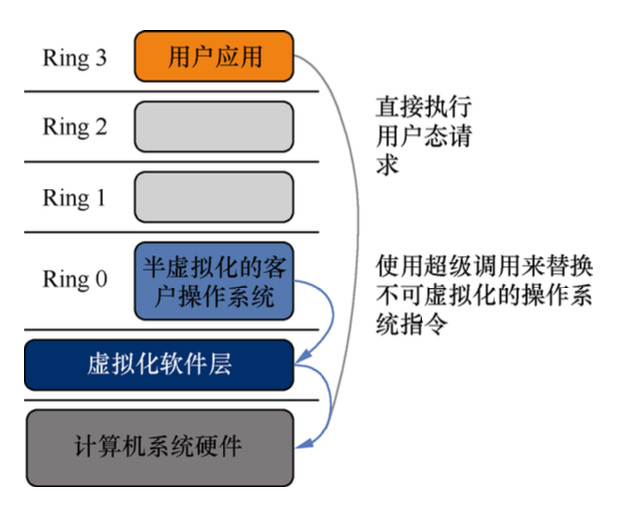
- 核心思想: 修改 Guest OS 内核,将敏感/特权指令替换为对 VMM 的直接调用 (Hypercall)。
- Hypercall: 类似于系统调用,由 Guest OS 主动发起,请求 Hypervisor 服务。
- 优点:
- VMM 与 VM 相互配合,性能优于全虚拟化(早期)。
- 虚拟化代价/开销更低。
- 缺点:
- 需要修改 Guest OS,不支持未修改的 OS (如 Windows)。
- 兼容性、可移植性差。
- 内核深度修改导致生产环境技术支持和维护困难。
硬件辅助虚拟化
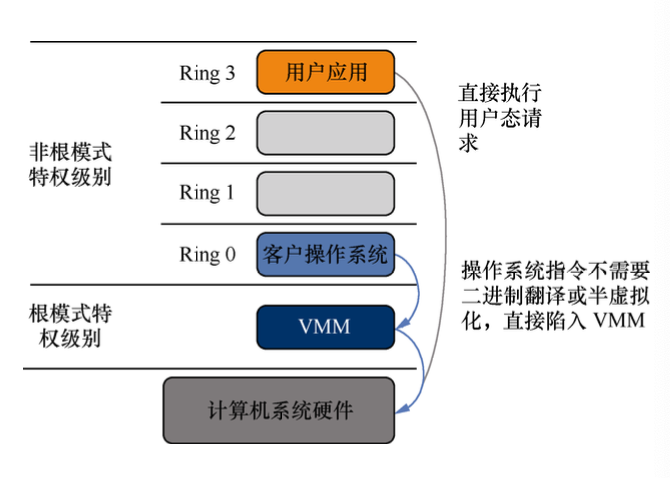
- 背景: 解决软件虚拟化性能开销。
- 技术: Intel VT-x (VMX), AMD AMD-V。
- 核心: CPU 增加新的操作模式。
- 根模式 (Root Mode): VMM/Hypervisor 运行。
- 非根模式 (Non-root Mode): 虚拟机 (Guest OS) 运行。
- 原理:
- Guest OS 在非根模式下执行。
- 执行敏感/特权指令时,CPU 自动触发 VM-Exit,控制权切换到根模式的 VMM。
- VMM 处理指令后,通过 VM-Enter 将控制权交还给 Guest OS。
- 优点:
- Hypervisor 无需费力识别/翻译敏感指令,极大提升虚拟化性能。
- Guest OS 无需修改。
虚拟化实现技术比较
| 特性 | 全虚拟化 (BT) | 半虚拟化 (Hypercall) | 硬件辅助虚拟化 |
|---|---|---|---|
| Guest OS 修改 | 无须修改 | 需要修改 | 无须修改 |
| 兼容性 | 好 | 差 | 好 |
| 性能 | 差 (相对) | 好 (早期) | 好 |
| CPU 虚拟化 | 二进制代码翻译 | 超级调用 | 新指令/新操作模式 |
| 内存虚拟化 | 影子页表 (SPT) | 内存管理半虚拟化 | 嵌套页表 (NPT/EPT) (硬件扩展) |
| I/O 虚拟化 | 设备模拟 | 半虚拟化驱动 | 设备模型 (直接访问) |
商用虚拟机技术
| 名称 | 发布年份 | 类型 | 技术特点 |
|---|---|---|---|
| VMware | 1999 | Type I, Type II | 商业产品先驱。支持 Type I (ESX Server) 和 Type II (Workstation)。提供完整虚拟化产品线 (桌面/应用/服务器)。 |
| Xen | 2003 | Type I | 开源。早期以半虚拟化为主。Linux 3.0 后稳定支持 Dom0/DomU。广泛部署 (硬件/车载等)。 |
| KVM/QEMU | 2006/2003 | Type II | 基于 Linux 内核的开源方案。硬件辅助虚拟化为主 (硬件不支持时退回 QEMU 软件模拟)。目前广泛部署。 |
| ACRN | 2018 | Type I | 嵌入式轻量级开源。代码量小 (~25K行)。注重实时性/安全性,面向车载/物联网等场景。 |
新型硬件虚拟化
背景
- GPU, FPGA 等新型硬件普及。
- 现有虚拟化技术主要面向通用硬件(x86)和软件栈(Linux/Win),无法高效承载新型硬件。
- 工业界/学术界探索新型硬件虚拟化方案,如 GPU/RDMA 直通独占式虚拟化。
- RDMA/FPGA 等虚拟化尚处早期。
硬件虚拟化的代表
- GPU 虚拟化:
- 性能/扩展性/可用性相对 CPU 滞后。
- 传统方式: API 转发 (VMM代理执行),非完整硬件虚拟化,性能/扩展性不足。
- 发展:
- 2013: AWS 推出商业化 GPU 实例。
- 2014: 主流 GPU 平台硬件辅助全虚拟化方案出现 (NVIDIA GPUvm, Intel gVirt)。
- 2017: Intel KVMGT (GPU全虚拟化方案) 加入 Linux 内核 4.10。
- FPGA 虚拟化:
- FPGA 是可重配置计算资源,与现有虚拟化框架不兼容,使用场景趋向独占。
- FPGA 器件与开发生态 (工具链/库) 紧密耦合,特定型号需特定软件生成二进制文件。
- 挑战: 缺乏统一的二进制接口规范。
- RDMA 虚拟化:
- RDMA (远程直接内存访问): 通过 DMA 实现主机间内存直接访问。
- 应用: 近年在 HPC 等领域探索 RDMA 硬件虚拟化。
- 实践: Microsoft Azure 尝试推出带 RDMA 网络支持的 VM 租赁服务。
- NVM 虚拟化:
- NVM (非易失性内存): 兼具内存高性能 (字节寻址) 和存储持久性。
- 挑战: 价格高、容量小、使用方式多变。虚拟化支持并投入云环境仍处研究起步阶段。
硬件虚拟化的未来
- 极端虚拟化:
- 宏观: 单机构建巨规模/巨型虚拟机 (因新型硬件增强单机能力)。
- 微观: 面向智能终端/极端受限环境的微型虚拟机 (便捷共享、高效抽象、按需重构、交互移动)。
- 异构硬件的融合和归一化:
- 基于“软件定义”原则,利用虚拟化融合 CPU, GPU, FPGA, RDMA网卡, NVM, SSD 等异构硬件。
- 实现异构硬件归一化管理,提供统一编程接口。
- 根据应用需求动态选择后台执行硬件。
- 多硬件和特性的聚合和抽象:
- 现状: 虚拟化侧重“一虚多”(单个物理资源 -> 多个虚拟资源)。
- 未来: 利用新型硬件实现“多虚一”,聚合多硬件/多特性,提升性能,突破单硬件物理极限。
实践: Xen 虚拟化技术
Xen 的历史
- 2003: Ian Pratt (剑桥) 发表论文,提出基于半虚拟化的 Xen 项目。
- 2005: Xen 3.0 支持 Intel VT/IA64,可运行完全未修改的操作系统。
- 2007: Citrix 收购 XenSource。
- 架构: Type I Hypervisor (裸金属),直接运行在硬件上。
- Hypervisor: 最底层,直接与硬件交互。
- Domain 0 (Dom0): 特权VM,运行控制工具栈、物理设备驱动。
- Domain U (DomU): 普通客户VM (Guest OS)。
Xen 实际操作 (概述)
- 检查 CPU 是否支持 Xen 虚拟化。
- 安装 Xen 相关软件包。
- 创建虚拟机 (使用
virt-manager或命令行工具)。- 选择虚拟化方法 (Paravirtualized / Fully virtualized)。
- 配置 VM 名称、内存、CPU、存储、网络等。
- 安装 Guest OS。
实践: KVM 虚拟化技术
KVM 简介
- 全称: Kernel Virtual Machine,Linux 内核提供的开源 Hypervisor,主流技术。
- 要求: 主机 x86 架构 + 硬件虚拟化支持 (Intel VT / AMD-V)。
- 架构: Type II Hypervisor (寄居架构)。
- 依赖: 需修改过的 QEMU (qemu-kvm) 作为虚拟机上层控制和界面。
- 技术: 以硬件辅助虚拟化为主。硬件不支持时,退回 QEMU 软件模拟 (动态二进制翻译实现 CPU 虚拟化)。
- 特点: 能在不改变 Linux/Windows 镜像下运行多VM,可配置个性化硬件环境。支持多种操作系统。
KVM 的基本安装操作 (概述)
- 安装 KVM 及其依赖包 (qemu-kvm, libvirt, virt-manager 等)。
- 启动
libvirtd服务,启动 Virtual Machine Manager (virt-manager) 图形界面。 - 配置桥接网络接口 (可选,使 VM 直接接入物理网络)。
- 创建虚拟机:
- 在
virt-manager中新建 VM。 - 选择安装方式 (本地 ISO/网络/导入磁盘等)。
- 配置 CPU、内存、存储、网络等。
- 安装 Guest OS。
- 在
Docker简介
Docker 为什么会出现? (面临的问题)
- 环境一致性问题: 开发环境(笔记本)、测试环境、生产环境配置各异,导致“在我机器上能跑”但在其他环境跑不起来。
- 部署复杂性问题: 配置应用运行环境需安装多种软件和依赖包 (Java/Tomcat/MySQL/JDBC等),过程繁琐、易出错且跨平台(Win/Linux)需重配,应用移植麻烦。
- 交付标准化问题: 传统交付物是程序/字节码,需附加部署文件和详细环境说明,运维部署易出错。
Docker 是什么?
- 基于 Linux 容器技术发展来的轻量级容器虚拟化技术。
- 核心思想: 解决代码在本机能运行,但在其他机器部署运行失败的问题。
- 实现方式: 通过镜像(Image) 将程序运行所需的环境、系统、配置、数据等自下而上打包,实现应用跨平台无缝运行,打破“程序即应用”观念。
- 目标: 提供系统平滑移植的标准化解决方案。
Docker 理念
- 核心目标: Build, Ship and Run Any App, Anywhere (构建、发布、运行任意应用在任意地方)。
- 实现: 通过应用组件的封装、分发、部署、运行等生命周期管理,使应用及其运行环境做到“一次镜像,处处运行”。
- 效果: 实现跨平台、跨服务器部署,只需一次配置环境,一键部署,简化操作。
Docker 定义总结
- 互联网行业热门技术,尤其在开发和运维方向,解决规模化、灵活化部署问题。
- 用于解决运行环境和配置问题,方便做持续集成,有助于整体发布的容器虚拟化技术。
容器与虚拟机比较
- 传统虚拟机技术:
- 带环境安装的解决方案 (如 Win10 里跑 CentOS)。
- 对应用程序透明,模拟完整系统。
- 缺点: 资源占用多 (需完整OS)、冗余步骤多 (启动OS)、启动慢 (分钟级)。
- 容器虚拟化技术 (Docker/LXC):
- 在操作系统层面实现虚拟化,直接复用宿主机操作系统内核。
- 隔离进程而非模拟完整OS,将软件运行所需资源打包到隔离容器中。
- 优点: 启动速度快 (秒级),占用体积小 (MB级 vs GB级)。
- 对比总结:
- 虚拟机: 虚拟硬件 -> 运行完整 Guest OS -> 运行应用。重。
- 容器: 直接运行于宿主内核 -> 隔离应用进程。轻。
- 隔离性: 虚拟机 > 容器。
Docker 能干嘛?
- 技术职位变化: Coder -> Programmer -> Software Engineer -> DevOps Engineer (体现了开发运维一体化趋势)。
- 一次构建、随处运行:
- 更快速的应用交付和部署: 打包应用及依赖成镜像,简化部署流程,节省配置测试时间。
- 更便捷的升级和扩缩容: 微服务架构下,容器如“积木”,升级/扩容只需操作对应容器镜像 (分钟级甚至秒级)。
- 更简单的系统运维: 应用容器化后,开发/测试/生产环境高度一致,减少环境问题,易于定位修复BUG。
- 更高效的计算资源利用: 内核级虚拟化,无 Hypervisor 额外开销,单机可运行更多容器,提升物理资源利用率。
- 应用场景:
- 借鉴标准集装箱思想,Docker 用于运输软件 (封装应用和依赖)。
- 适用于各种应用场景 (静态网站、用户数据库、Web前端、消息队列、数据库等)。
- 开发 -> 测试 -> 生产环境迁移,保证环境一致性。
- 使用企业: 微博、美团、蘑菇街等众多互联网公司广泛应用Docker进行私有云实践和业务部署。
Docker的安装
下载与准备
- 官网: https://www.docker.com
- 仓库: https://hub.docker.com
- 前提说明: Docker 依赖 Linux 内核。在 Windows/Mac 上部署 Docker,实质是先安装一个 Linux 虚拟机,然后在虚拟机内运行 Docker。
- 系统要求: CentOS 7 (64-bit),Linux 内核版本 >= 3.8。
- 查看内核:
uname -r,cat /etc/redhat-release
Docker 三要素
- 镜像 (Image):
- 用于创建 Docker 容器。一个镜像可创建多个容器。
- 本质是一个文件系统 (e.g.,
centos:7包含最小化 CentOS 7 系统)。 - 类似 Java 的 类 (静态定义)。
- 容器 (Container):
- 用 Docker 镜像创建的运行实例。
- 类似虚拟化运行环境,应用程序/服务运行其中。
- 类似 Java 的 对象实例 (运行时实体)。
- 提供标准隔离环境 (启动/停止/删除)。
- 看作简易版 Linux 环境 + 运行的应用。
- 仓库 (Repository):
- 集中存放镜像文件的场所。
- 类似 Maven 仓库 (存 jar) 或 Github 仓库 (存 git 项目)。
- 分公开仓库 (Public) 和私有仓库 (Private)。
- 最大公开仓库: Docker Hub (官方)。国内有阿里云、网易云等。
Docker 平台架构
- Client-Server 结构:
- Docker Client: 用户与 Docker 交互的命令行工具或 UI。
- Docker Daemon (守护进程): 运行在主机上,接收并处理 Client 命令,管理容器。
- 通信: Client 通过 Socket 与 Daemon 通信。
- 容器: Daemon 管理的运行时环境 (集装箱)。
Docker 平台架构及通信原理简述
- 用户使用 Docker Client 与 Docker Daemon 建立通信并发送请求。
- Docker Daemon 作为 Server 接收请求。
- Docker Engine 执行内部工作,每个工作是一个 Job。
- 需要镜像时,从 Docker Registry 下载,通过 Graph driver 以 Graph 形式存储。
- 需创建网络时,通过 Network driver 创建配置容器网络。
- 需限制资源或执行指令时,通过 Exec driver 完成。
- 底层通过 Libcontainer (独立容器管理包) 实现对容器的具体操作 (Network/Exec driver 都调用它)。Namespace 实现资源隔离,Cgroups 实现资源控制。
Docker 安装步骤
测试 hello-world
docker run hello-world: 运行测试镜像。- 流程: 本地无镜像 -> 从 Docker Hub 拉取 -> 运行容器 -> 输出信息 -> 容器退出。
底层原理: Docker 为何比 VM 快?
- 更少的抽象层: Docker 无需 Hypervisor 实现硬件虚拟化,直接使用宿主机硬件。
- 共享宿主机内核: Docker 容器共享宿主机 OS 内核,无需加载额外 OS 内核。避免了 VM 启动引导、加载 OS 内核等耗时过程。
- 结果: VM 创建是分钟级,Docker 容器创建是秒级。
Docker常用命令
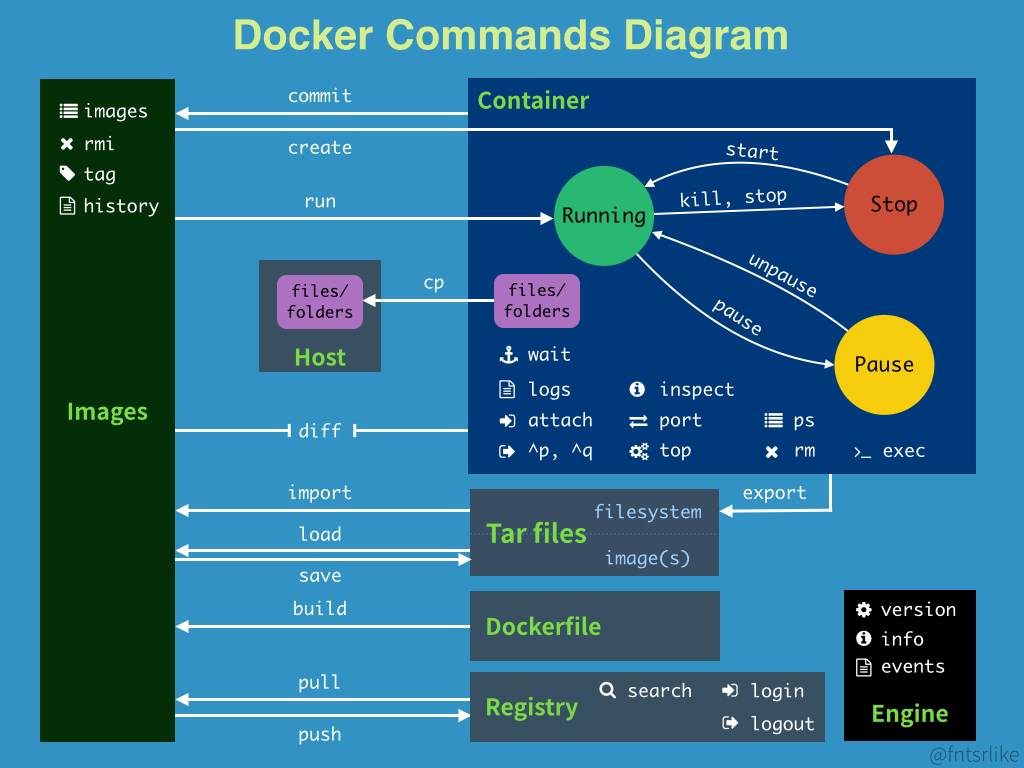
帮助启动类
systemctl start/stop/restart/status/enable dockerdocker info: 查看 Docker 系统信息。docker version: 查看 Docker 版本信息。docker --help: 查看 Docker 帮助。docker COMMAND --help: 查看具体命令帮助。
镜像命令
docker images/-a/-q/--digests/--no-trunc: 列出本地镜像 (所有/仅ID/摘要/完整信息)。docker search <image_name>: 在 Docker Hub 搜索镜像。docker pull <image_name>[:TAG]: 下载镜像 (默认 latest)。docker rmi <image_name_or_id>/-f: 删除未使用镜像 (强制删除)。可删除多个。docker system df: 查看 Docker 资源占用 (镜像/容器/数据卷)。- 虚悬镜像 (Dangling Image): 仓库名和 TAG 均为
<none>的镜像。
容器命令
docker run [options] IMAGE [command] [arg...]: 新建并启动容器。-i: 交互模式。-t: 分配伪终端。-d: 后台运行 (守护式容器)。
docker ps/-a/-q: 列出正在运行的容器 (所有/仅ID)。exit: 退出并停止容器 (交互式)。Ctrl+P+Q: 退出容器但不停止 (交互式)。docker start/restart/stop/kill <container_name_or_id>: 启动/重启/停止/强制停止容器。docker rm <container_name_or_id>/-f: 删除已停止的容器 (强制删除运行中容器)。docker logs [options] <container_name_or_id>: 查看容器日志 (-t时间戳,-f跟随,--tail N最后N条)。docker top <container_name_or_id>: 查看容器内运行的进程。docker inspect <container_name_or_id>: 查看容器内部细节 (JSON格式)。docker exec -it <container_id> /bin/bash: 进入正在运行的容器并执行命令 (exit 不停止容器)。docker attach <container_id>: 重新附加到容器终端 (exit 会停止容器)。docker cp <container_id:src_path> <host_dest_path>: 从容器内拷贝文件到宿主机。
Docker镜像
镜像是什什么?
- 轻量级、可执行的独立软件包。
- 包含运行应用所需的一切: 代码、运行时、库、环境变量、配置文件。
- 用于生成 Docker 容器实例。
分层的镜像
docker pull过程显示镜像是一层一层下载的。
联合文件系统 (UnionFS)
- Docker 镜像由一层层文件系统组成,这种层级文件系统即 UnionFS。
- 特性: 分层、轻量级、高性能。支持将文件系统修改作为一次提交层层叠加。可将不同目录挂载到同一虚拟文件系统下,对外透明。
- 基础: UnionFS 是 Docker 镜像的基础。镜像通过分层继承,基于基础镜像(无父镜像)制作应用镜像。
Docker 镜像加载原理
- bootfs (boot file system): 包含 bootloader 和 kernel。Linux 启动时加载,完成后内核接管内存,bootfs 被卸载。各发行版一致,可共享。
- rootfs (root file system): 位于 bootfs 之上,包含
/dev,/proc,/bin,/etc等标准目录和文件。代表不同操作系统发行版 (Ubuntu, CentOS)。不同发行版有差别。 - 精简 OS 的 rootfs 可以很小,只需基本命令/工具/库。
Docker 镜像采用分层结构的好处
- 镜像特点: Docker 镜像是只读的。容器启动时,在镜像顶部加载一个可写层 (容器层)。
- 分层优点:
- 共享资源: 多个镜像若基于相同 Base 镜像构建,Host 只需存一份 Base 镜像。内存中也只需加载一份 Base 镜像,供所有容器共享。
- 方便复制迁移与复用。
Docker 镜像 - commit 操作
docker commit -m "message" -a "author" <container_id> <target_image_name>[:TAG]- 将容器的当前状态 (包括其可写层的修改) 提交,生成一个新的镜像。
总结
- Docker 镜像分层,支持通过扩展现有镜像创建新镜像 (类似 Java 继承)。
- 新镜像是从 Base 镜像一层层叠加生成。每次安装软件,都在现有镜像基础上增加一层。
容器数据卷 (Volume)
是什么?
- 用于持久化容器数据,解决容器删除后数据丢失问题。
- 是宿主机上的一个目录或文件,通过 Docker 挂载到容器中。
- 独立于联合文件系统 (UFS),生命周期独立于容器。
容器内添加数据卷
docker run -it -v /host_absolute_path:/container_path[:ro] <image_name>- 将宿主机目录与容器内目录绑定。两者内容实时同步。
:ro表示只读挂载 (容器内不可写)。
容器数据卷的特点
- 可在容器间共享或重用。
- 容器与宿主机间数据共享,修改即时生效。
- 数据卷的更改不包含在镜像更新中 (commit 不会打包数据卷内容)。
- 数据卷生命周期持续到没有容器使用它为止 (容器删除,数据卷不会被删除)。
数据卷的继承和共享
docker run -it --volumes-from <source_container_name> --name <new_container_name> <image_name>- 新容器 (
u2) 可以继承另一个容器 (u1) 挂载的数据卷。
Dockerfile 解析
是什么?
- 用来构建 Docker 镜像的文本文件。
- 包含一系列命令和参数构成的脚本。
- 内容定义了镜像构建过程: 执行代码、设置环境变量、安装依赖包、指定运行时环境、操作系统发行版等。
- Docker 通过读取 Dockerfile 指令自动构建镜像。
Dockerfile, 镜像, 容器的关系 (类比)
- Dockerfile: 软件原材料 (中药处方)。 面向开发。
- Docker 镜像: 软件交付品 (抓好的中药)。 成为交付标准。
- Docker 容器: 软件镜像的运行态 (熬出的中药汤)。 涉及部署与运维。
Dockerfile 构建过程解析
- 基础知识:
- 每条保留字指令必须为大写字母且后跟至少一个参数。
- 指令按从上到下顺序执行。
#表示注释。- 每条指令都会创建一个新的镜像层并对镜像进行提交。
- 大致流程:
- Docker 从基础镜像运行一个容器。
- 执行一条指令,对容器作出修改。
- 执行类似
docker commit的操作,提交一个新的镜像层。 - Docker 再基于刚提交的镜像运行一个新容器。
- 重复 2-4 步,直到所有指令执行完毕。
Dockerfile 常用保留字指令
- FROM: 指定基础镜像。
- MAINTAINER: 镜像维护者姓名和邮箱 (已废弃,推荐用 LABEL)。
- WORKDIR: 指定容器工作目录 (后续 RUN/CMD/ENTRYPOINT/COPY/ADD 指令在此目录下执行)。
- ENV: 设置环境变量。
- VOLUME: 定义匿名数据卷,用于数据保存和持久化。
- EXPOSE: 声明容器运行时对外暴露的端口 (仅声明,实际端口映射在
docker run -p指定)。 - ADD: 复制文件/目录到镜像。支持 URL,且自动解压 tar 压缩包。
- COPY: 类似 ADD,复制文件/目录到镜像。不支持 URL 和自动解压。
- RUN: 在镜像构建时执行命令 (e.g., 安装软件)。
- CMD: 指定容器启动时默认执行的命令。Dockerfile 可有多个 CMD,只有最后一个生效。会被
docker run后面的命令覆盖。 - ENTRYPOINT: 指定容器启动时执行的命令。不会被
docker run后面的命令覆盖,参数会传递给 ENTRYPOINT 指定的程序。
RUN, CMD, ENTRYPOINT 对比
- RUN: 构建时执行。
- CMD: 容器启动时执行 (默认命令,可被覆盖)。
- ENTRYPOINT: 容器启动时执行 (入口点,不可被覆盖,参数追加)。
- Note: RUN 在构建时运行并提交到镜像;CMD 在构建时不执行,在容器启动时执行,指定默认命令。
案例: 自定义镜像 centosjava8.0
- 需求: 基于 CentOS 7,安装 vim, ifconfig, JDK 8。
- 步骤:
- 准备基础环境 (CentOS 7 镜像,JDK tar 包)。
- 编写 Dockerfile (使用 FROM, MAINTAINER, ENV, WORKDIR, RUN, ADD, CMD 指令)。
- 构建镜像:
docker build -t <image_name>:<tag> .(注意最后的点表示 Dockerfile 路径)。 - 运行容器:
docker run -it <image_name>:<tag>。 - 验证 (检查 java -version, ifconfig)。
虚悬镜像 (Dangling Image)
是什么?
- 镜像列表中,仓库名 (REPOSITORY) 和标签 (TAG) 都显示为
<none>的镜像。 - 通常是由于构建了新镜像,覆盖了旧镜像的 TAG 导致旧镜像失去引用名。
查看
docker image ls -f dangling=true
删除
docker image prune: 删除所有虚悬镜像。