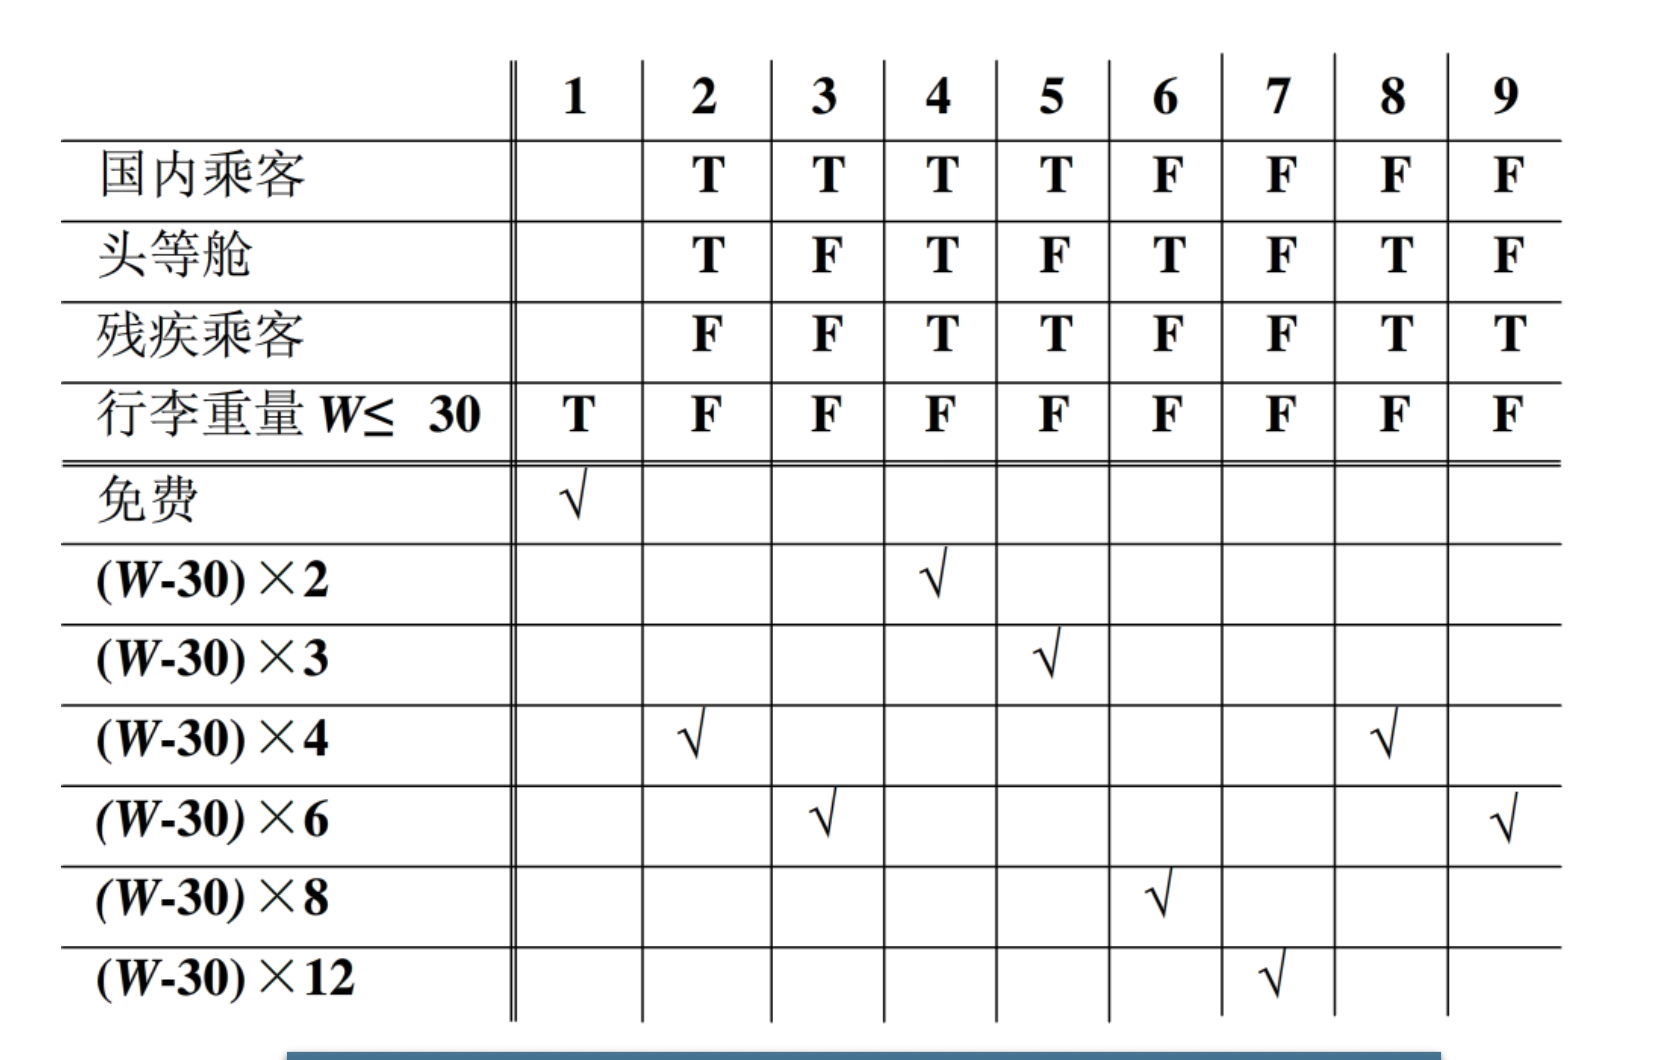
判定表
| 条件 | 条件 1 | 条件取值的组合 |
| 条件 2 | ||
| ... | ||
| 条件 n | ||
| 动作 | 动作 1 | 动作 |
| 动作 2 | ||
| ... | ||
| 动作 n |
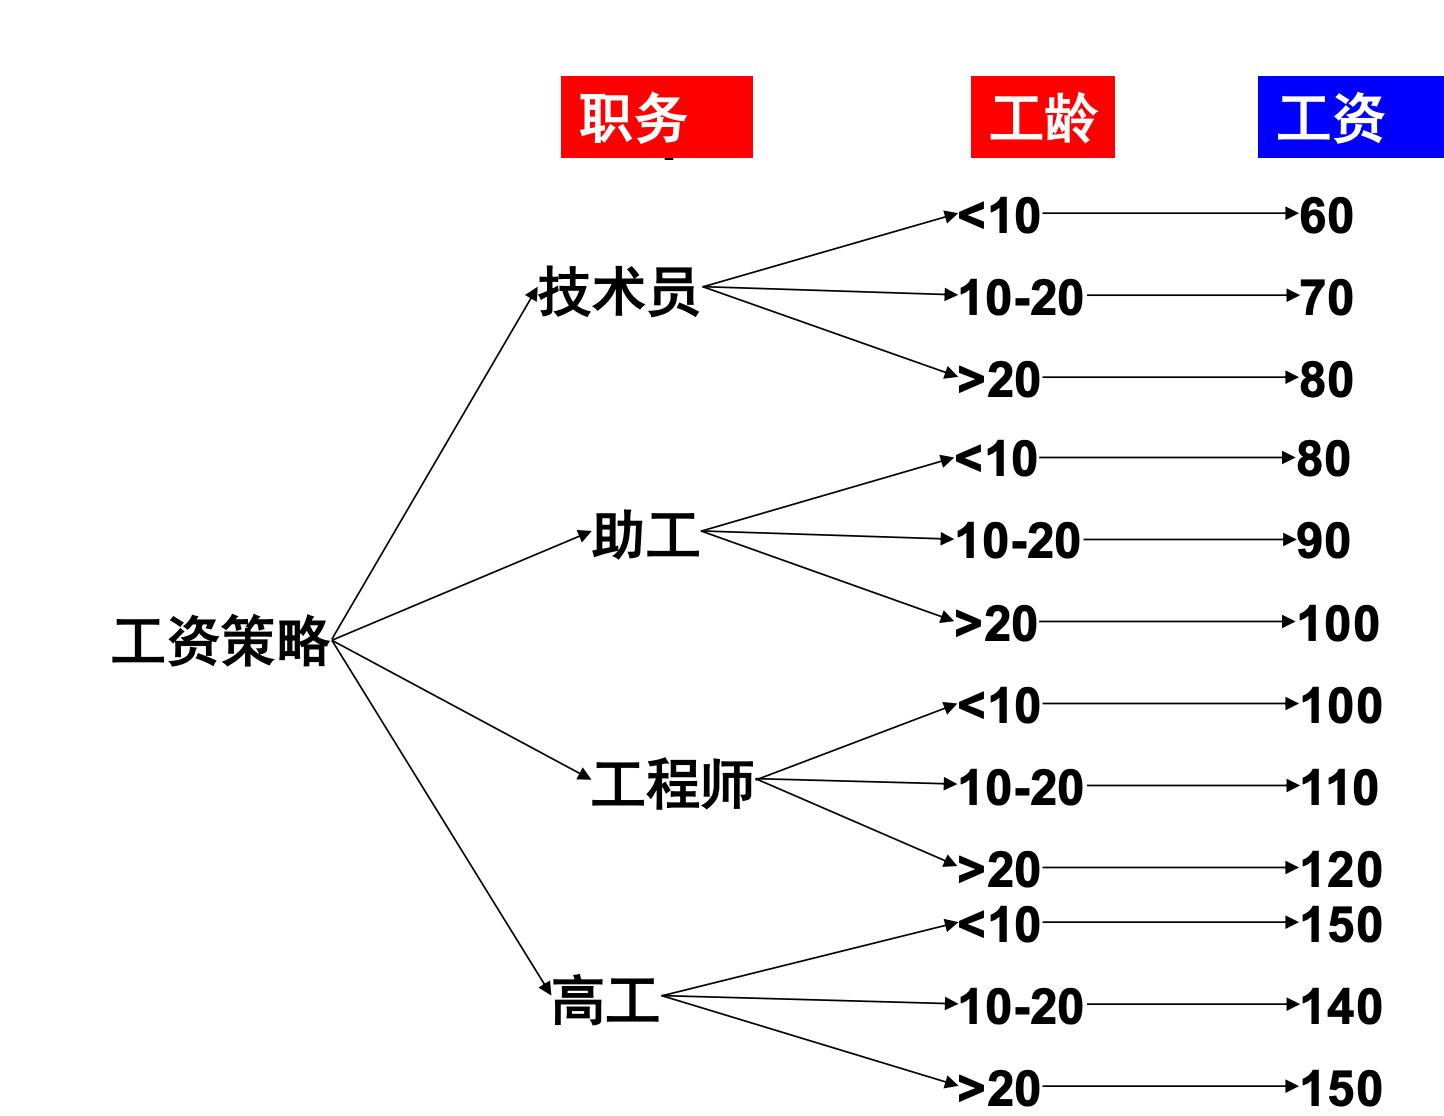
判定树
SA画DFD
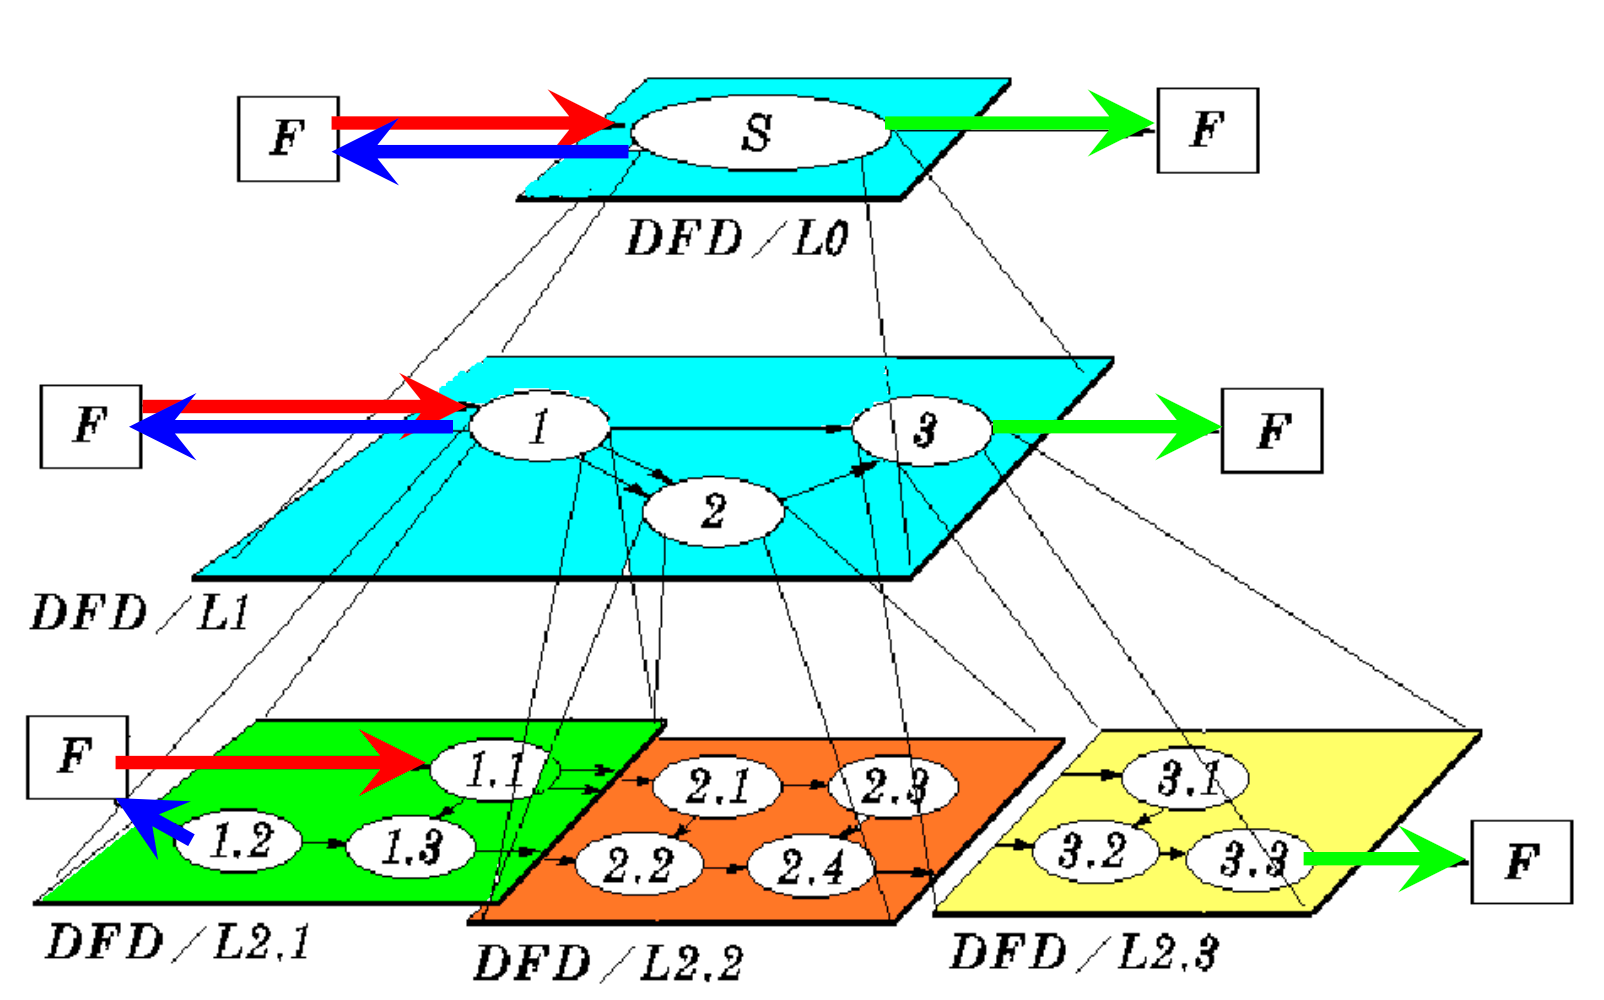
DFD步骤
- 从顶层DFD开始,把整个系统视为加工处理。
- 自上而下,逐步对系统分解:
- 每分解一次,增加系统的加工元素,进一步具体化每个加工的功能。
- 重复第2步,直到所有的加工元素都是足够简单,功能足够单一,视不必再分解为止。
- 不再分解的加工——“基本加工”
DFD原则
- 父/子图平衡(I/O)
- 如果一张数据流图中的某个加工分解成另一张数据流图时,则上层图为父图,直接下层图为子图。把一个处理分解为一系列处理时,分解前和分解后的输入/输出数据流必须相同。
- 区分流程先后和层次。
- 每个子图应该对应唯一的父加工。
- 区分全局文件和外部项。
- 画数据流而不是控制流。
- 数据流反映系统“做什么”,不反映“如何做”,因此箭头上的数据流名称只能是名词或名词短语。
- 一般不画物质流。
- 数据流反映能用计算机处理的数据,并不是实物。
- 每个加工至少有一个输入数据流和一个输出数据流,反映出此加工数据的来源与加工的结果。
- 加工框编号。
- 子图及其所有的加工都应编号,便于引用和追踪。
- 掌握分解的速度。
- 一般一次引入2~7个加工处理。
- 外部实体之间不能有数据流。
UML
UML用例图
用例图元素
-
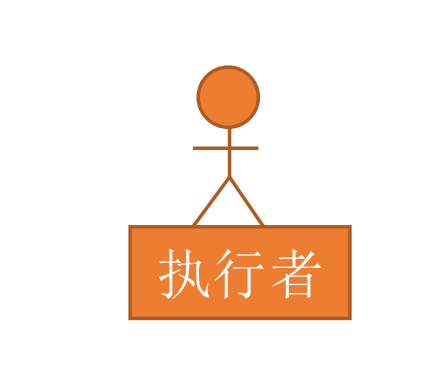
Actor:参与者
-
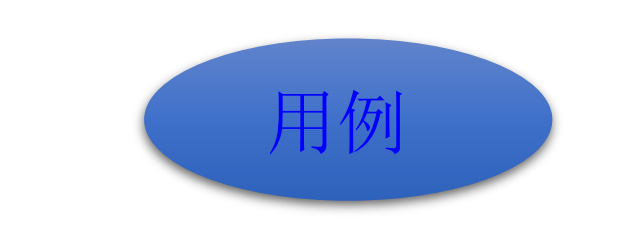
Use Case:用例
-
Communication Association:通信关联
-
Use Case说明系统需要提供什么而不是怎么提供
-
用户并不关心你如何给他们提供所需要的功能
-
Use Case一般是用“动宾”短语命名
用例图角色
与系统发生交互作用的、系统之外的任何东西都是角色:
- 可以是人
- 也可以是机器
- 角色不等同于使用者
- 角色存在于系统外部
- 角色不是活动的准确描述
- 使用者是行使某个角色职责的系统的使用人员
- 每个Actor都通过不同的方式使用系统,除非他们是相同的Actor
- Actor使用系统的每一种方式就是一个Use Case
用例图步骤
- 找出拟建系统以外的Actor
- 与系统交互的人员
- 与系统相连并交换信息的设备和其他系统
- 使用Use Case来描述Actor怎样使用系统以及系统向Actor提供什么功能
- Use Case表示从外部用户角度观察的系统功能
- 绘制Use Case图,并编写详细的Use Case描述
- Use Case图只能宏观地描述系统的功能
- 每个功能的含义和具体实现步骤则以文本方式描述
用例图关联
Include
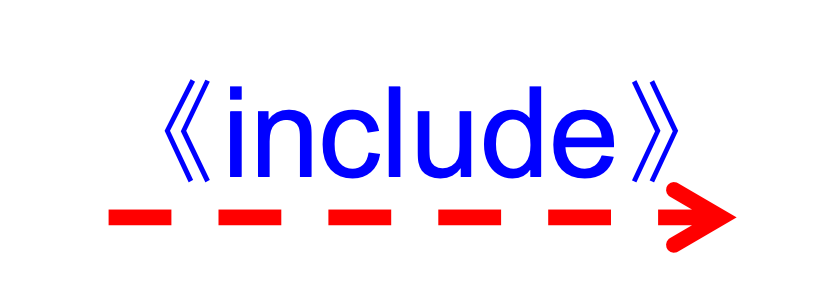
- Use Case中的包含关系。
- 通常发生在多个Use Case中,有可以提取出来的公共部分。
如果用例A确实要调用到用例B,那么,可以进一步分析:
用例A是调用了用例B的所有流程呢,还是其中部分流程?
- 如果是调用部分流程,此时可以把用例B中的那部分流程提取出来,形成用例C,然后用例A和用例B都 include 用例C。
- 如果是调用所有流程,那么,用例A直接 include 用例B即可。
Extend
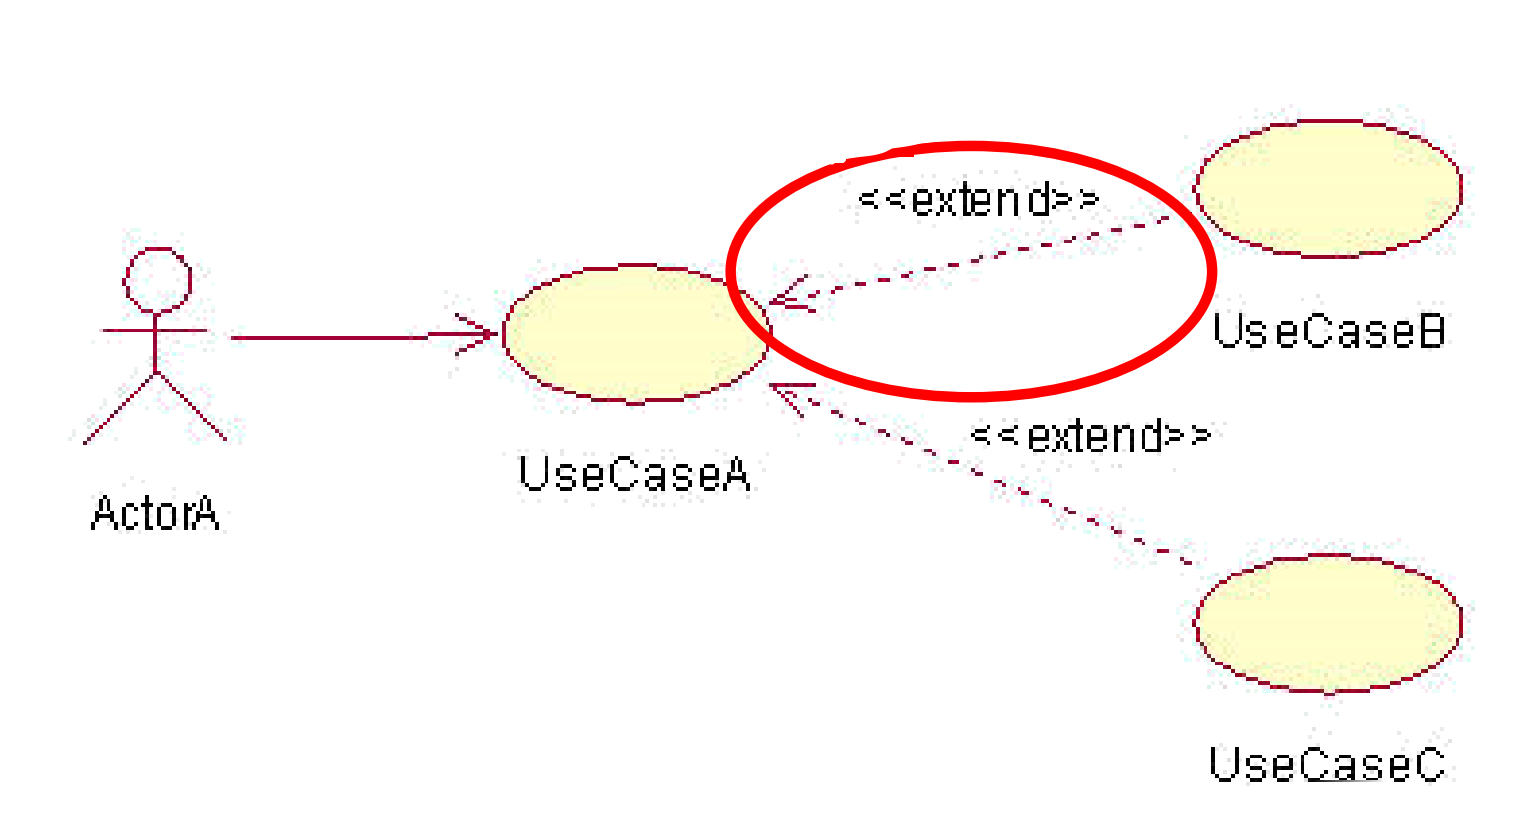
- UseCaseA 不知道 UseCaseB 和 UseCaseC 的存在
- UseCaseB 和 UseCaseC 却是知道 UseCaseA 并且知道如何在 UseCaseA 中作扩展的
泛化关系
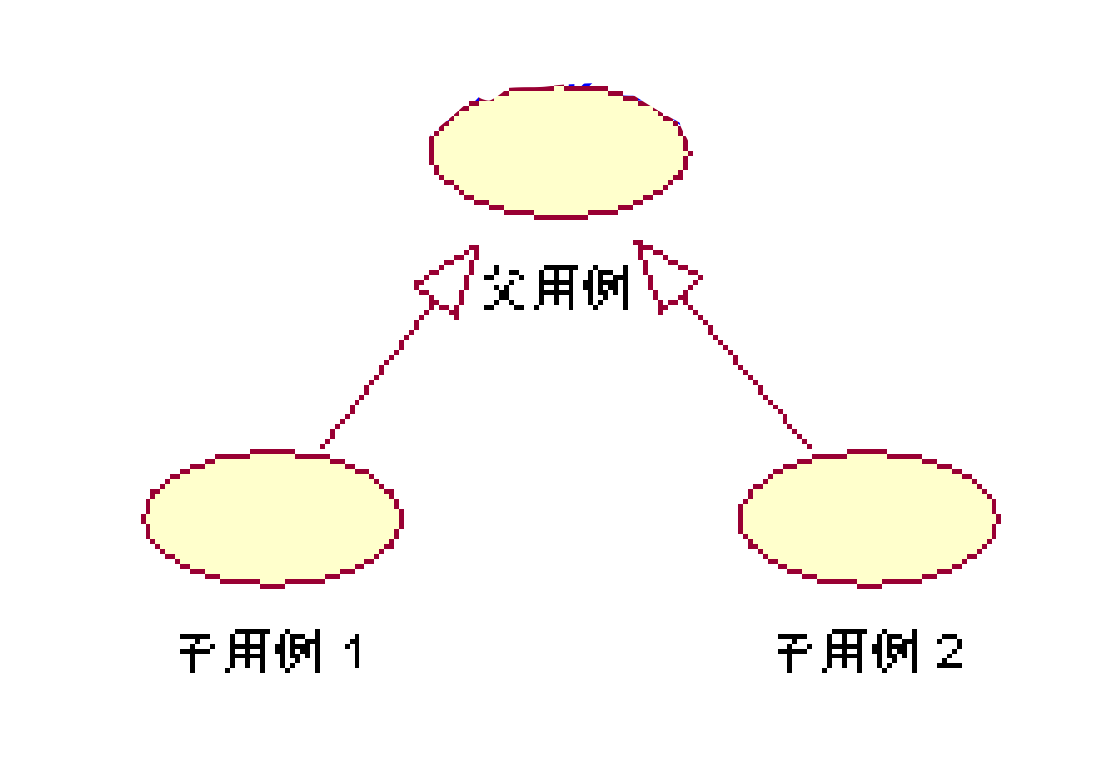
- 当多个用例共同拥有一种类似的结构和行为的时候,将它们的共性抽象成为父用例,其他的用例作为泛化关系中的子用例。
- 子用例继承了父用例所有的结构、行为和关系。
- 在实际应用中很少使用泛化关系。
用例图规则
- 主动角色画在图的左边
- 被动角色画在图的右边
- 每个 Use Case 必须为用户提供确切的功能
- Use Case 名称必须写在椭圆里面
- 每一张图里不能有太多的 Use Case
- 为每一个 Use Case 编号便于检索
- 为 Use Case 建立目录(编号和名称)便于管理
- 保持图面整洁
发现对象
实体类
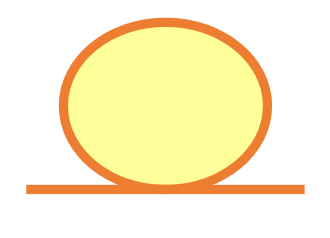
代表拟建系统要记录和维护的信息,同时描述其相关行为。需要长期保存。
边界类
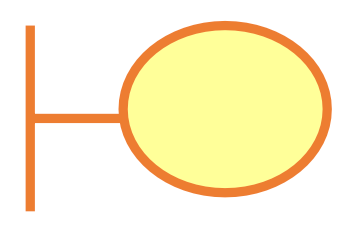
拟建系统和外部元素之间交互的边界,一个Actor和Use Case之间的通信关联对应一个边界类
- 用户界面;
- 与外部系统的接口;
- 与其他设备的接口;
控制类
将Use Case所有的执行逻辑进行封装,相当于协调人。
- 自己不处理具体的任务。
- 知道哪些类有能力完成具体的任务
作用:
将拟建系统的其他部分(实体类和边界类)与Use Case的具体执行逻辑形成松散耦合。
获取方法:一个Use Case对应一个控制类。
类图
-
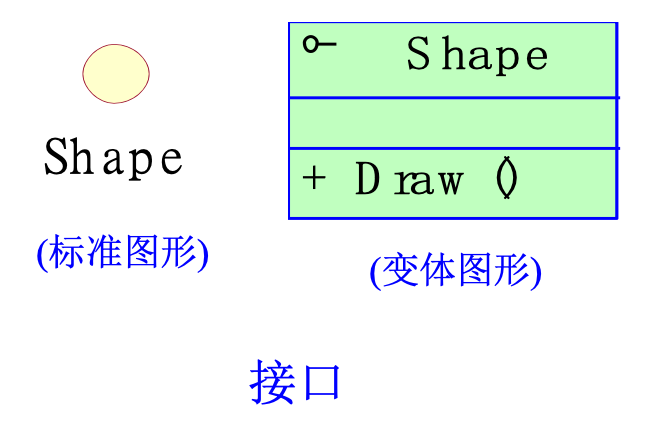
接口:一组操作的集合,只有操作的声明而没有实现
-
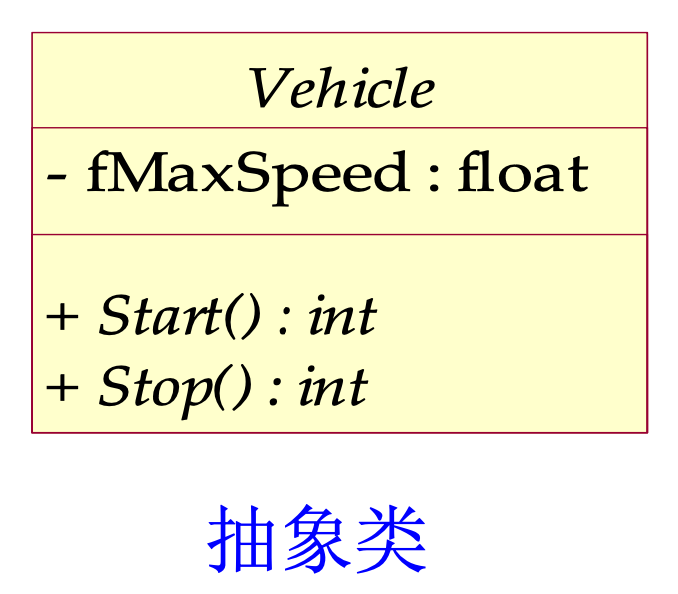
抽象类:不能被实例化的类,一般至少包含一个抽象操作
-
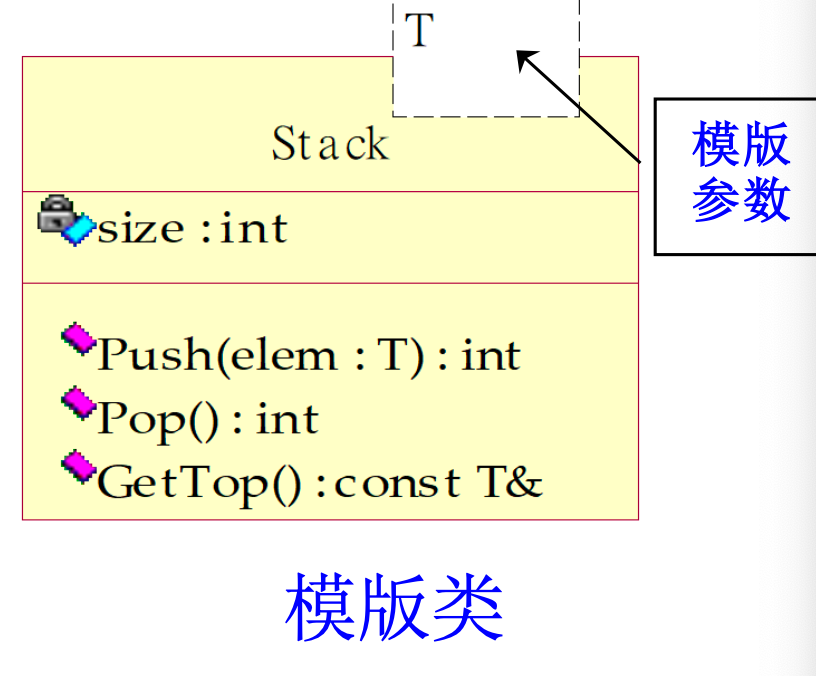
模版类:一种参数化的类,在编译时把模版参数绑定到不同的数据类型,从而产生不同的类
对象之间关系
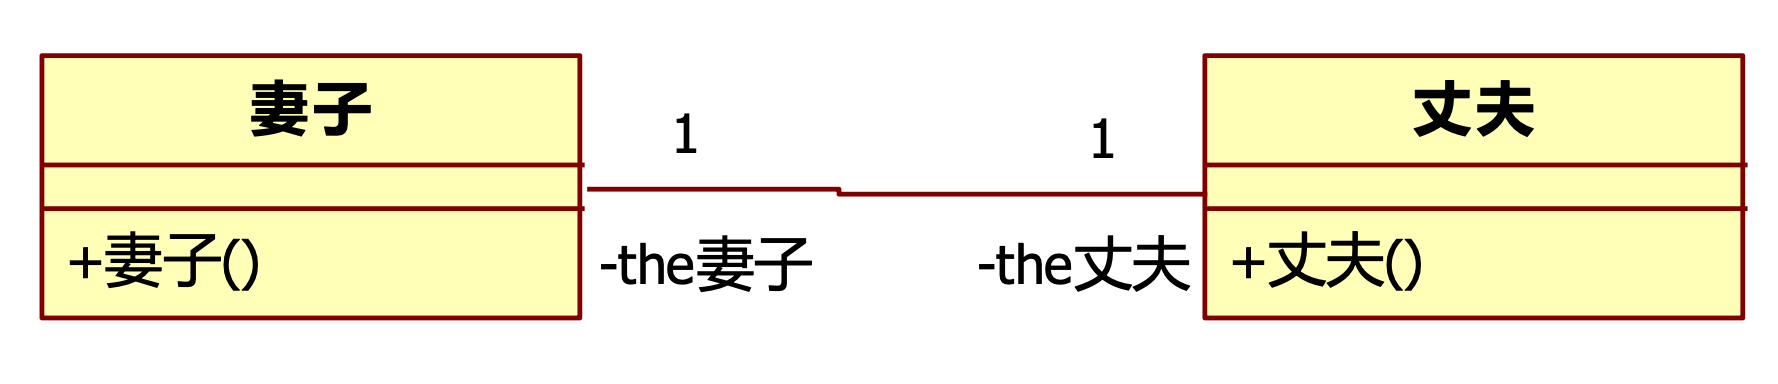
关联
一个类的对象(实例)作为另一个类的对象的变量成员时,两个类之间有关联关系
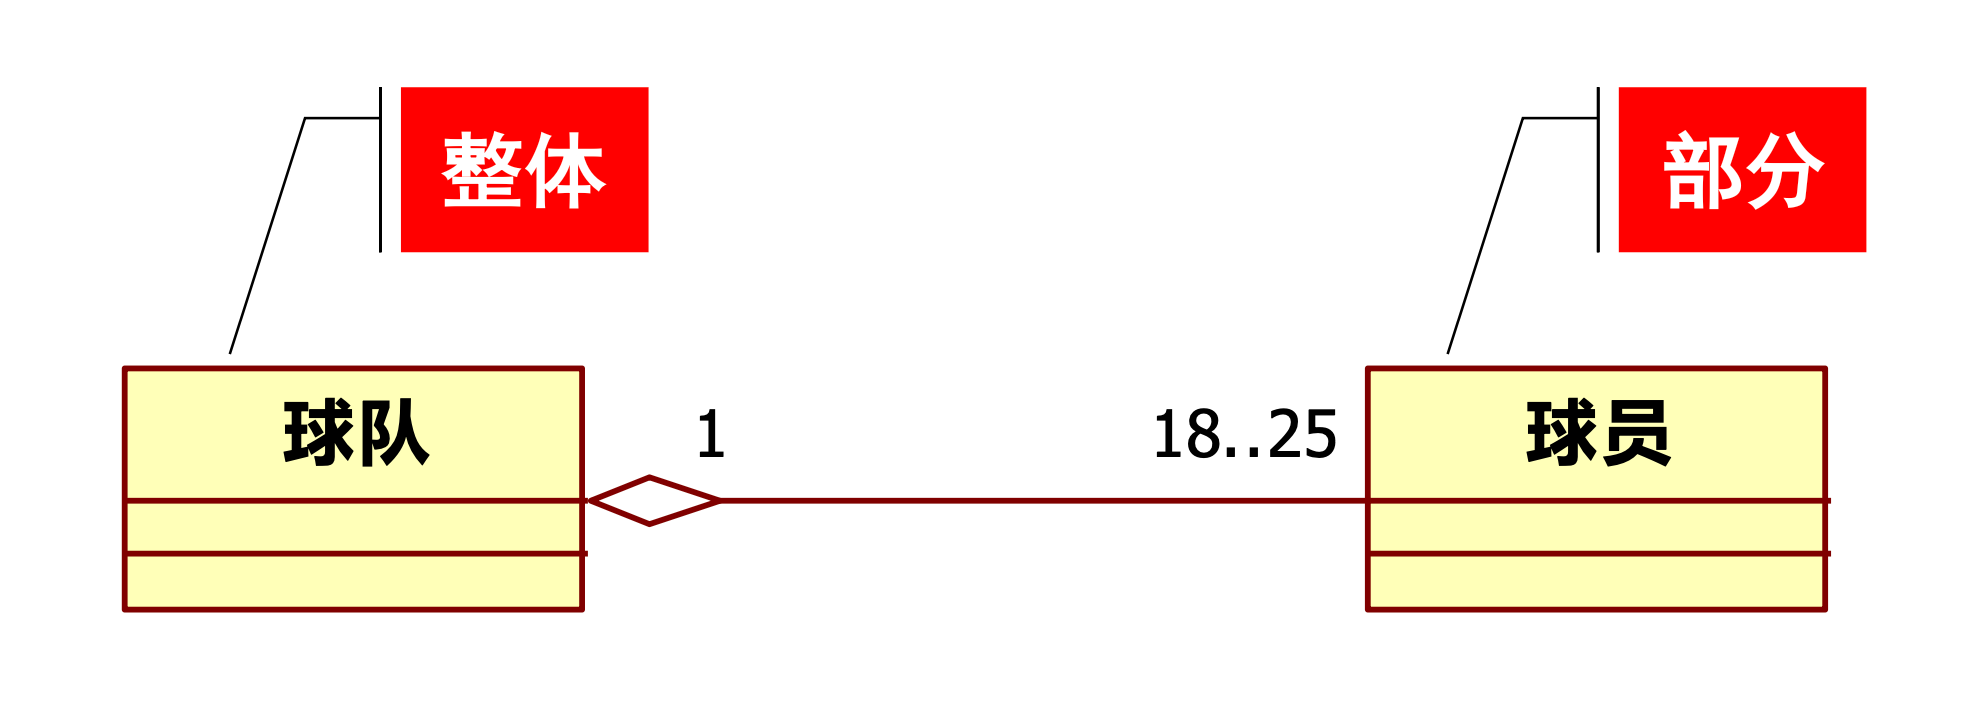
聚合
表示两个类的对象间有“整体”与“部分”的关系。
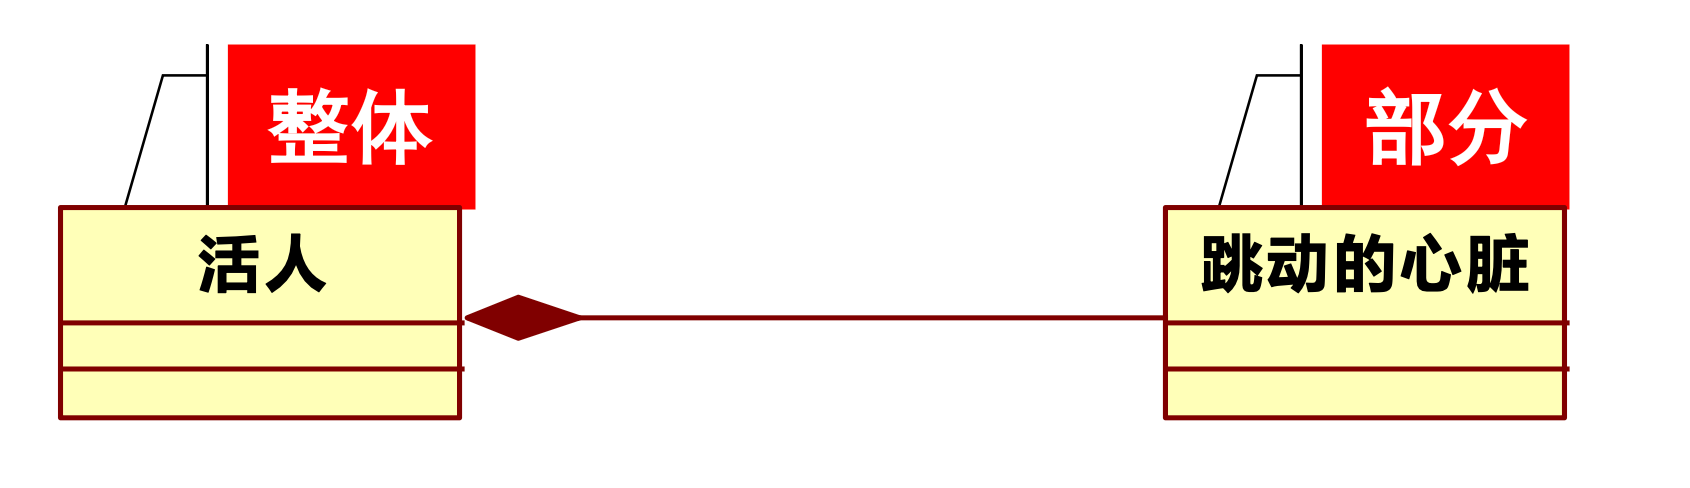
组合关系
“整体”与“部分”间有“皮之不存,毛将焉附”的语义。
“部分”不能被“整体”共享。
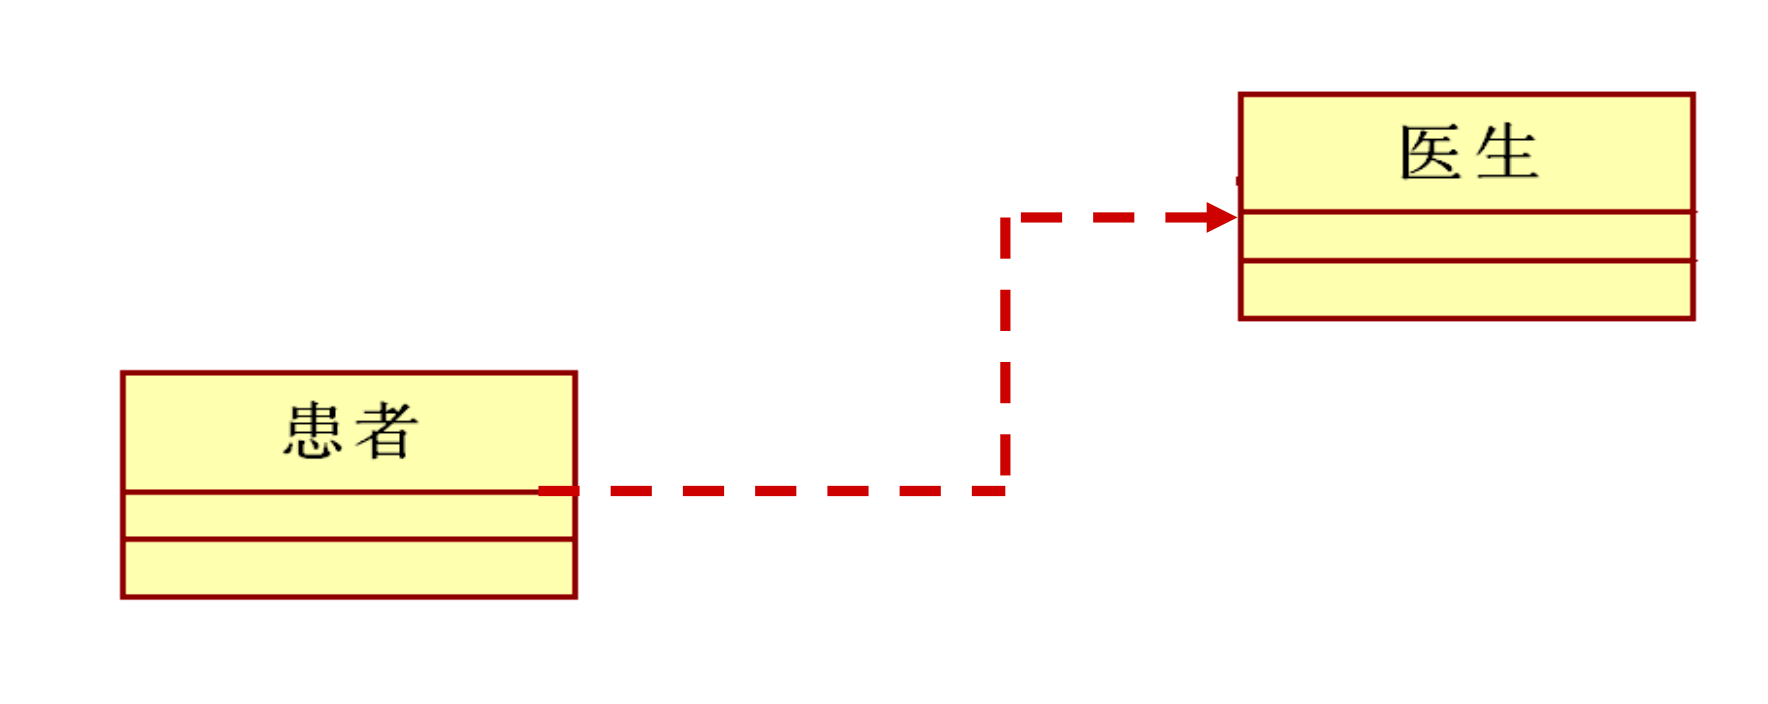
依赖关系
表示“使用”的语义,是一种比较弱的关系。
对象作为参数、全局变量或者局部变量被另外一个对象使用
友元依赖:授权一个对象访问对象的私有或者保护成员
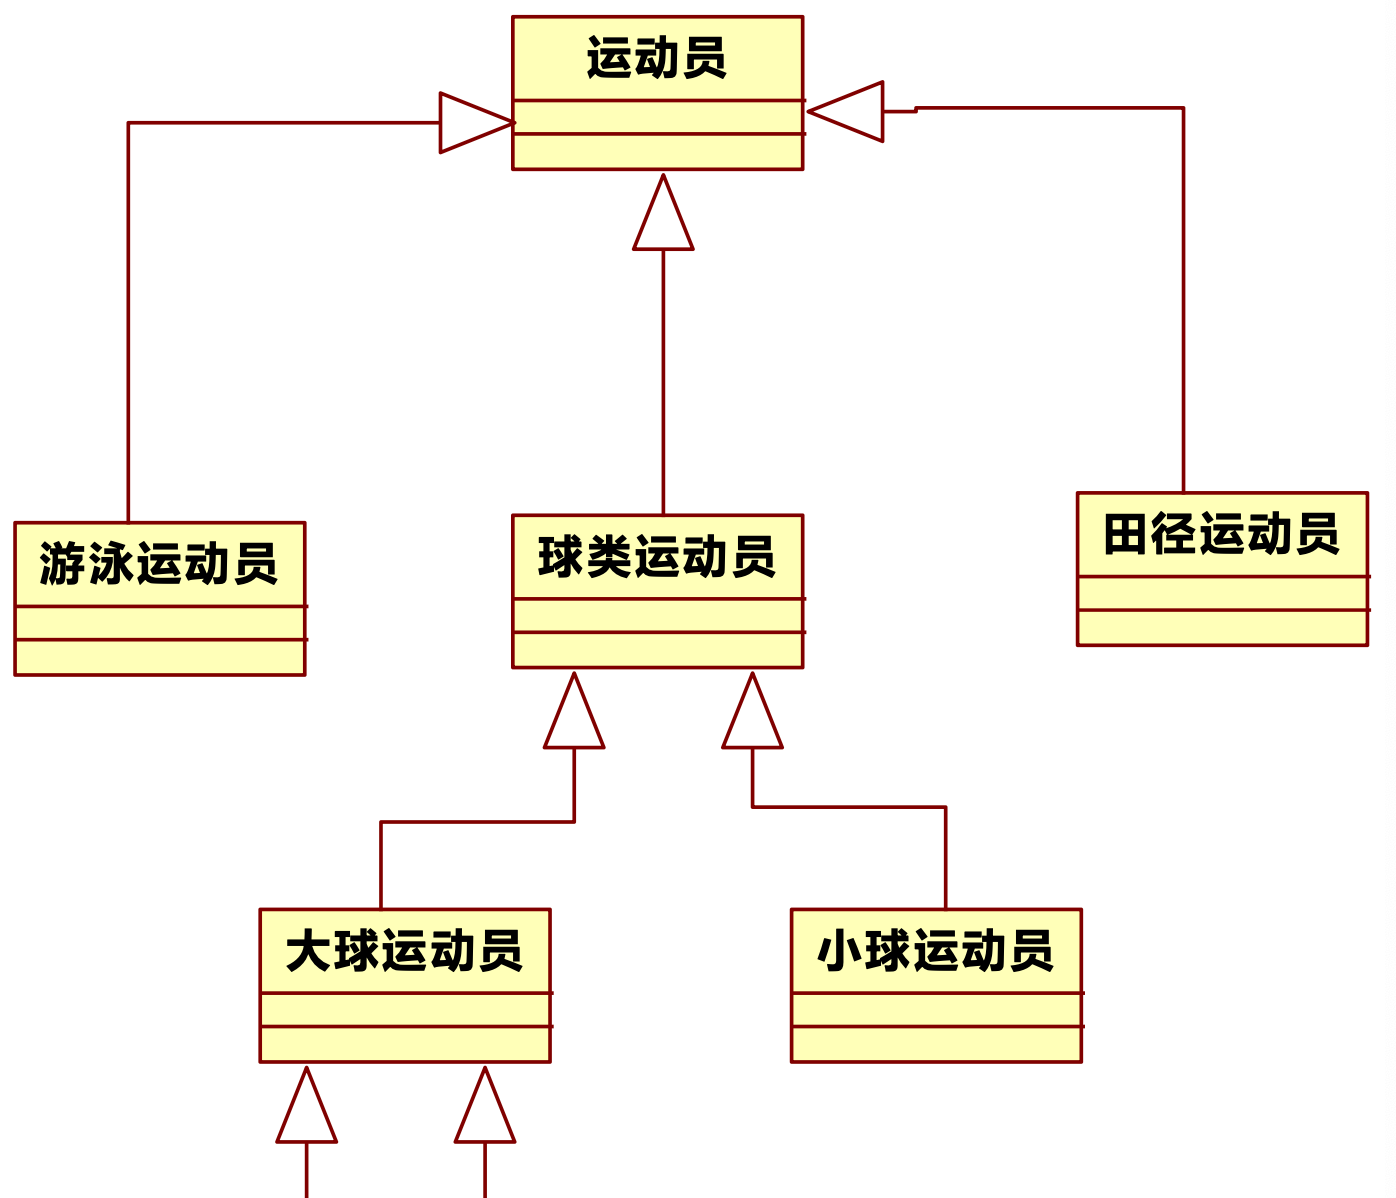
泛化关系
类A(特殊)到类B(一般)的泛化关系表示“类A是类B的一种”。
- 类A——子类
- 类B——父类
泛化关系有助于代码共享和复用。
- 共同的属性放在上层,而将特有的属性放在下层;
- 共同的服务放在上层,而将特有的服务放在下层
泛化关系 vs. 继承
- 泛化关系是一种关系的名称。
- 继承是一种实现泛化关系的机制。
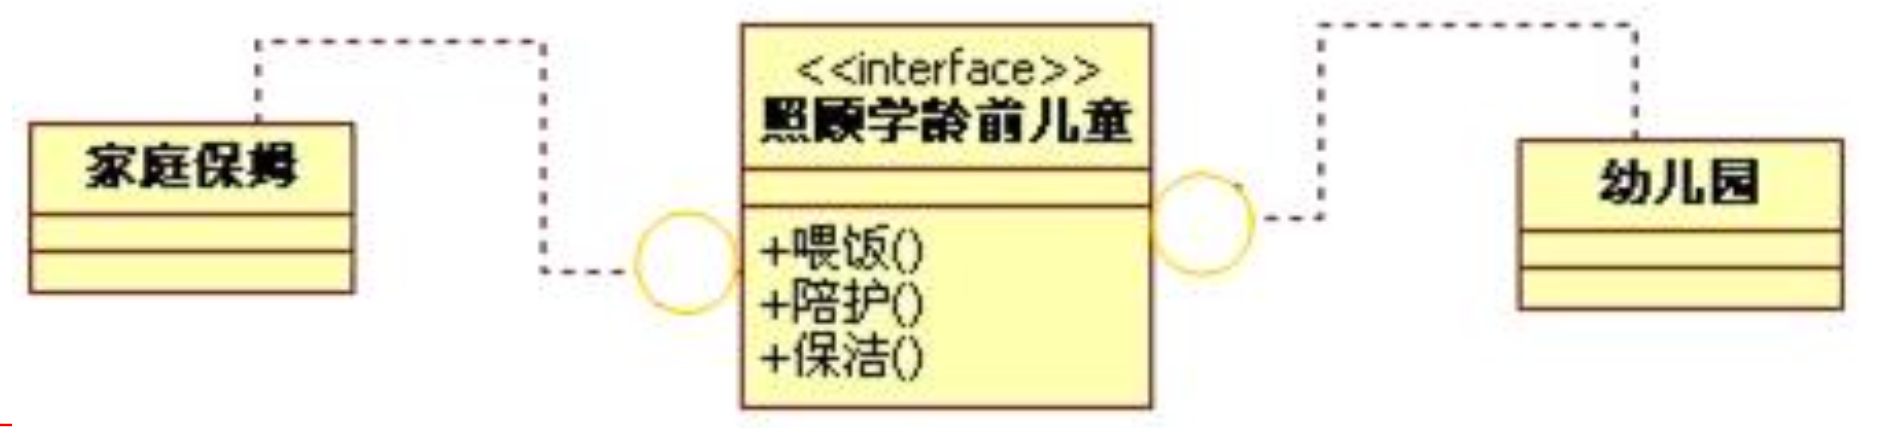
实现关系
描述类实现接口
构件图
构件图描述代码部件的物理结构及各部件之间的依赖关系。
- 是比“类”更大的实体,例如一个 COM 组件、ActiveX 文件、一个 JavaBeans、进程内组件(.DLL)、进程外组件(.EXE)、C++ 中的头文件(.h)、实现文件(.cpp)等等。
- 它包含逻辑类或实现类的有关信息。
- 构件图有助于分析和理解部件之间的相互影响程度。
| 事务名称 | 含义 | 图例 |
|---|---|---|
| 构件 | 指系统中可替换的物理部分 | 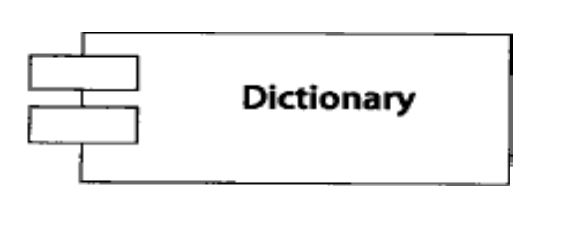 |
| 接口 | 外部可访问到的服务 | 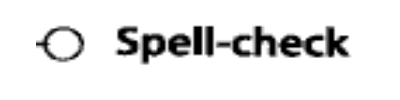 |
| 构件实例 | 节点实例上的构件的一个实例,冒号后是该构件实例的名字 | 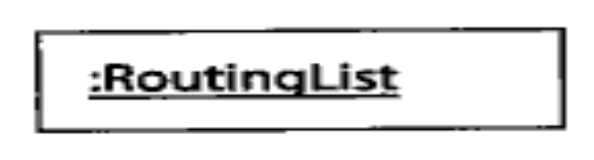 |
构件图中的关系及解释
- 依赖关系:构件依赖外部提供的服务 (由构件到接口), 用虚线表示
- 实现关系:构件实现接口 (由构件到接口), 用实线表示
部署图
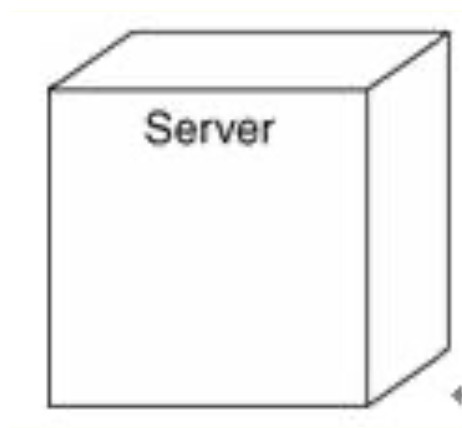
- 节点是在运行时存在的物理元素,它表示一个计算机资源,通常至少有一些记忆能力和处理能力。
- 一组构件可以驻留在一个节点内,也可以从一个节点迁移到另一个节点。
- 在图形上,把节点画成一个立方体,通常在立方体中只写它的名称。
顺序图
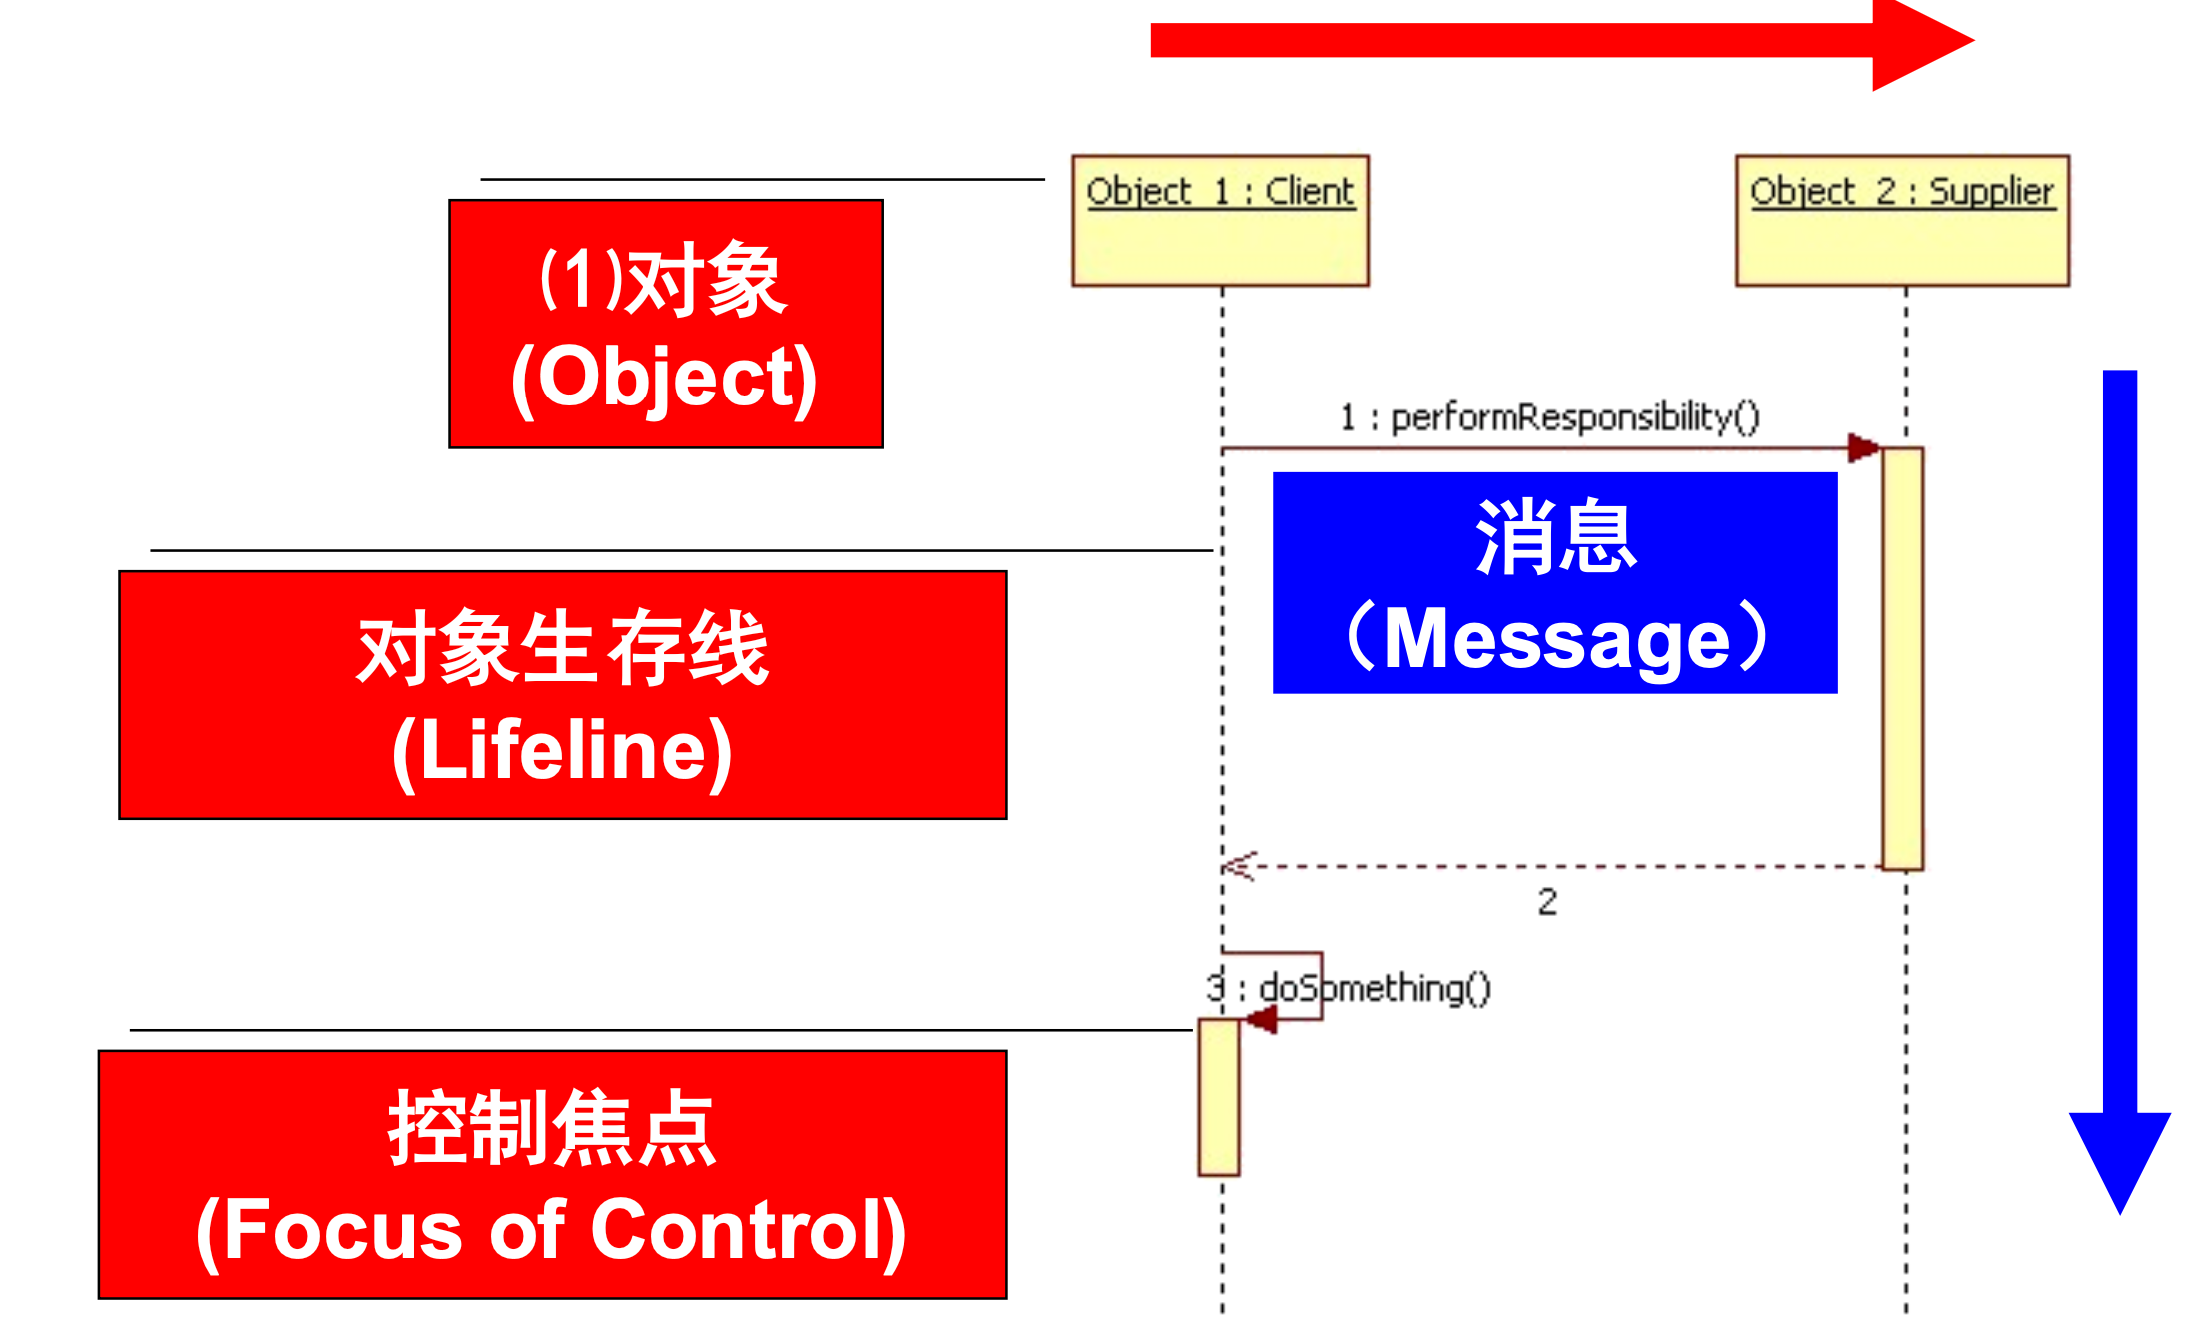
顺序图的组成
顺序图的消息
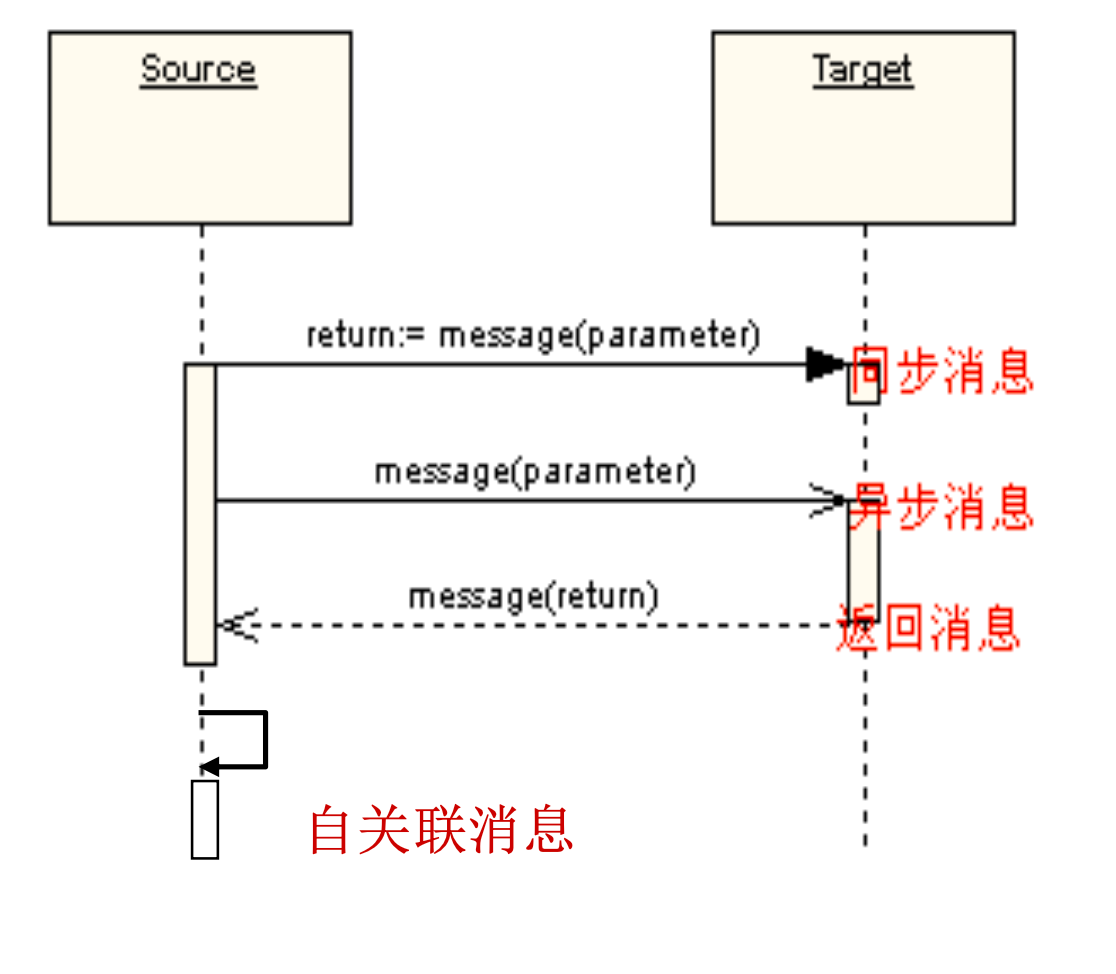
消息包含3个部分:
- 序号
- 名称
- 参数
消息的4种类型:
- 同步消息:消息的发送者把控制传递给消息的接收者,然后停止活动,等待消息的接收者放弃或者返回控制。
- 异步消息:消息发送者通过消息把信号传递给消息的接收者,然后继续自己的活动,不等待接收者返回消息或者控制。异步消息的接收者和发送者是并发工作的。
- 返回消息:返回消息表示从过程调用返回。
- 自关联消息:表示方法的自身调用以及一个对象内的一个方法调用另一个方法。
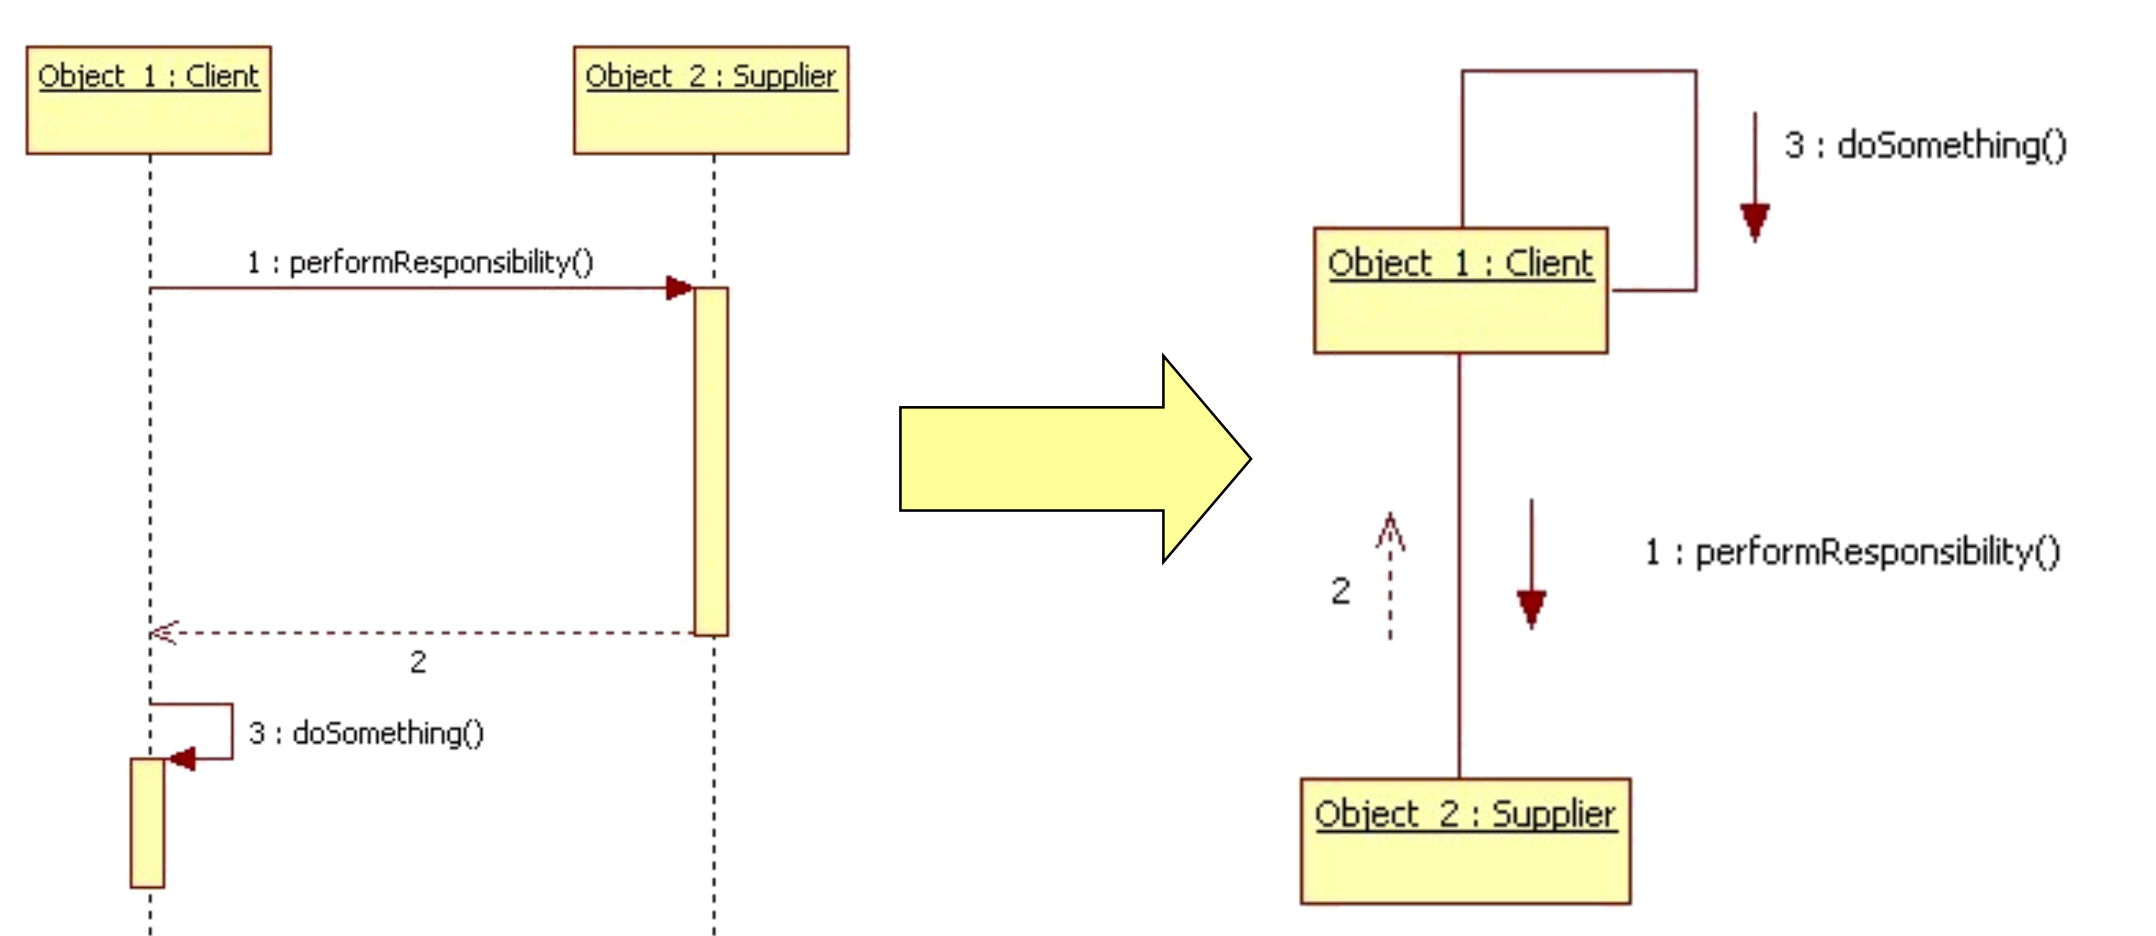
协作图
与相关的顺序图有明确的对应关系。
状态图
- 状态图用来建模系统中的某个类对象、子系统或整个系统在其生命周期内出现的状态、状态的迁移和迁移条件。
- 一个对象在某个时刻所处的状态是由该对象的属性值所决定的。
- 对象由一种状态迁移到另一种状态,通常是由于受到了外部的刺激或自身性质的改变所引起的。导致对象状态变迁的原因即迁移条件。
状态图符号
-
用导角矩形表示对象所处的状态
-
开始状态:必须有
-
终止状态:可选的,也可以没有

-
带箭头的直线表示状态迁移的方向,其状态迁移的条件写在直线的上方或下方
活动图
活动图用于描述Use Case的事件流结构;属于一个特定的Use Case。
活动之间带箭头的直线表示从一个活动到另一个活动的转移,可在直线上标注活动转移的条件
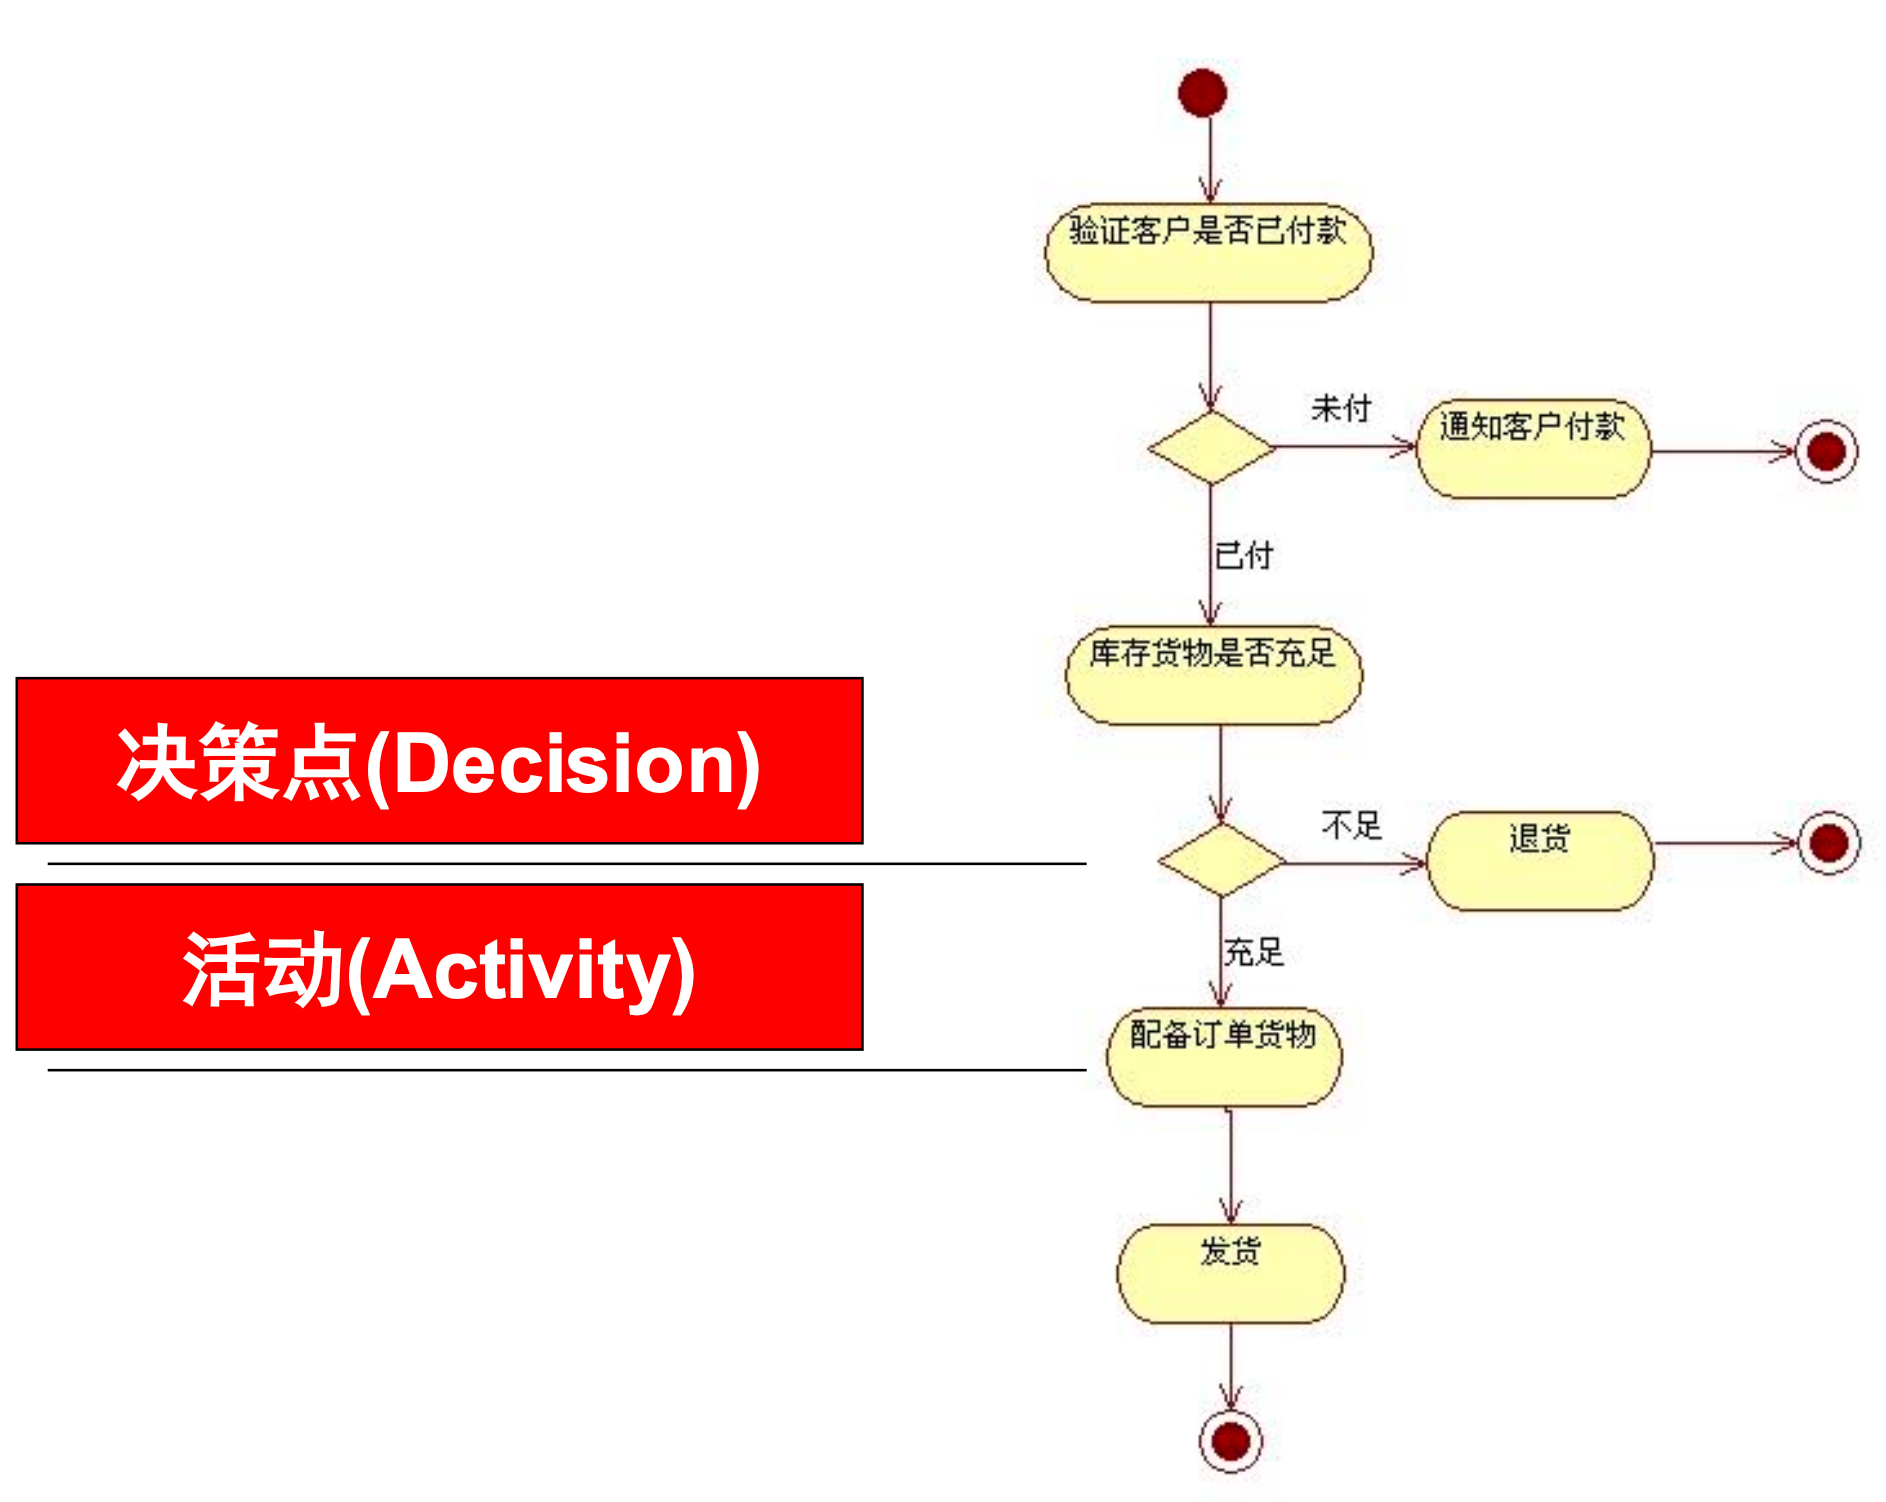
- 用圆角矩形表示活动
- 用黑色实心圆和“牛眼”分别表示活动的开始和终止
- 活动之间带箭头的直线表示从一个活动到另一个活动的转移,可在直线上标注活动转移的条件
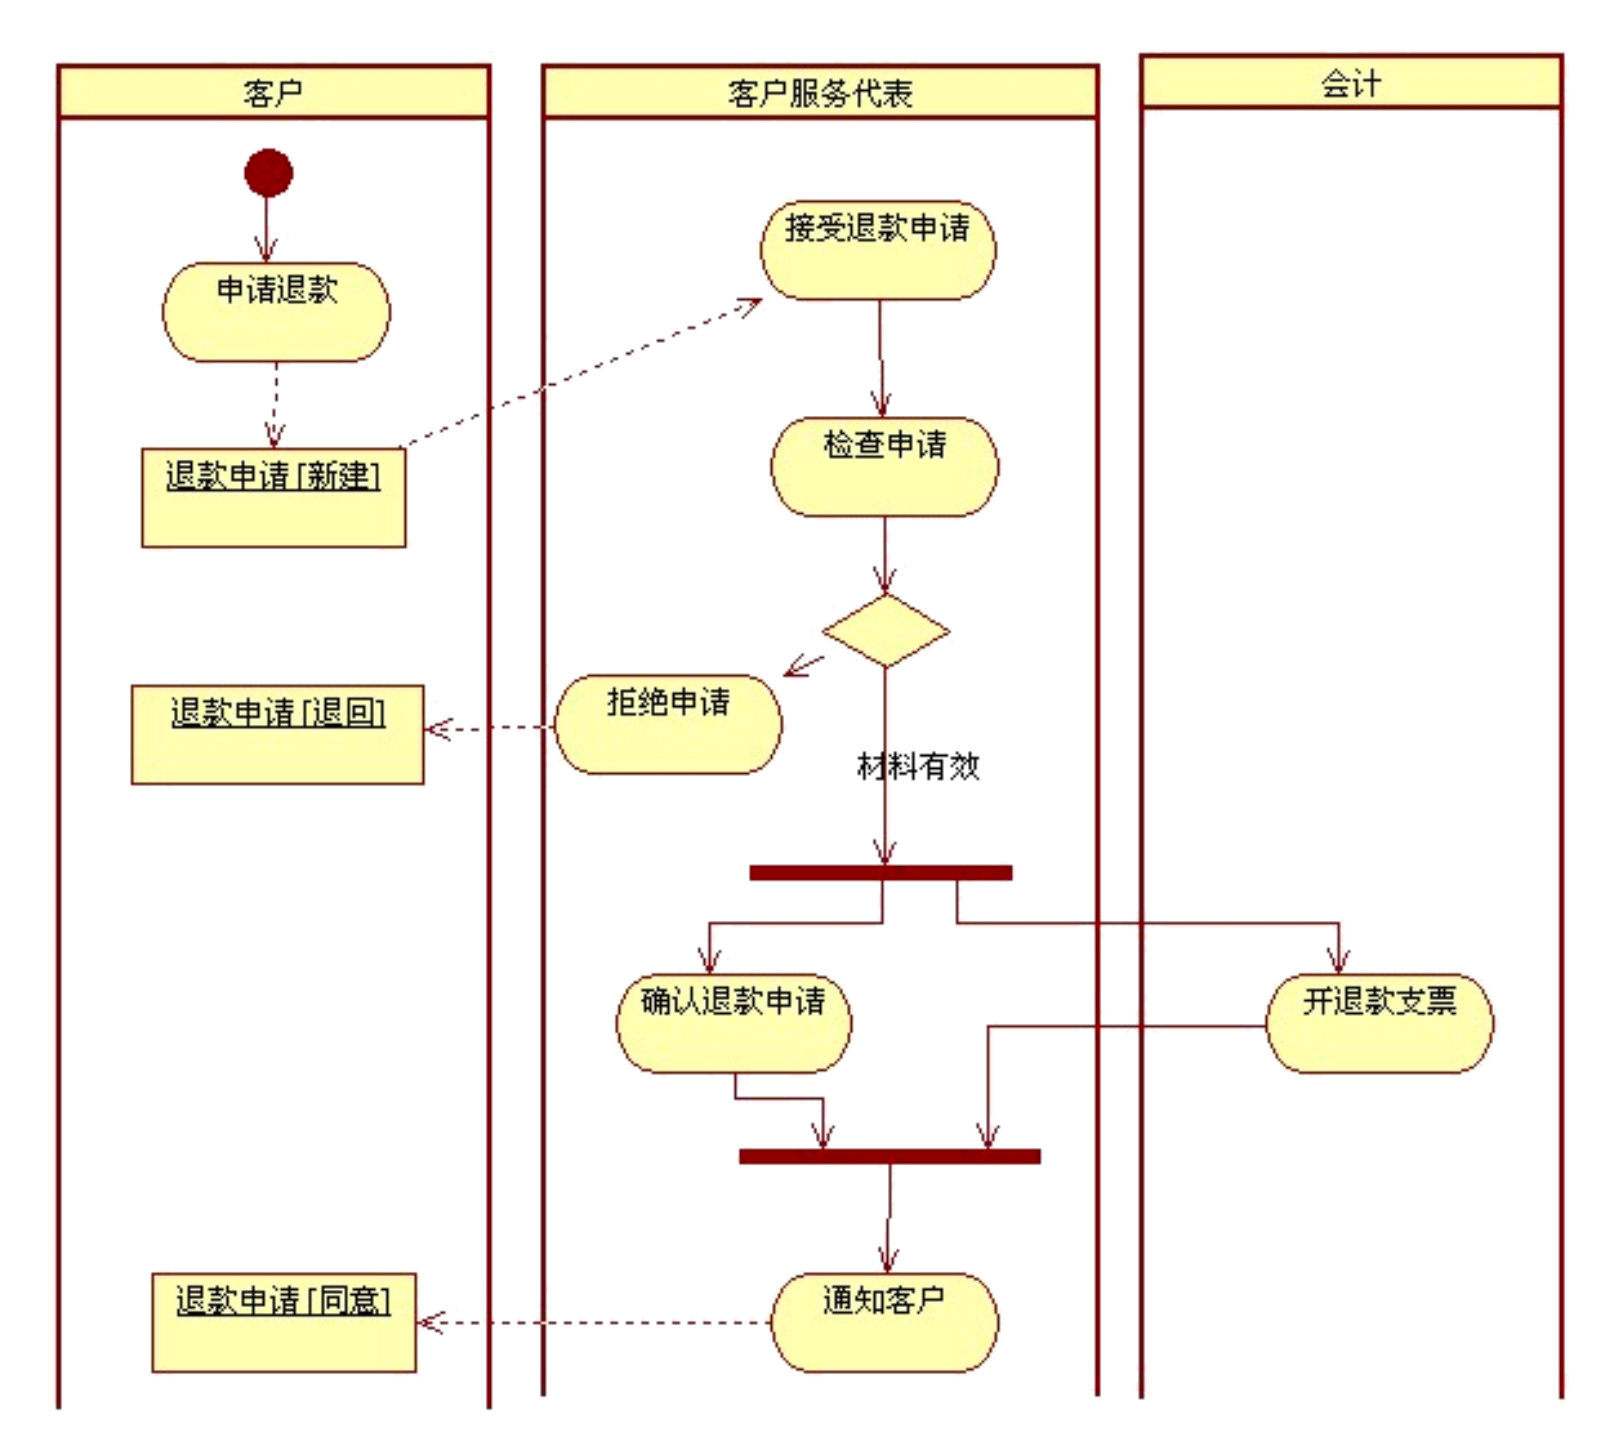
- 泳道不仅表示出活动的变化,而且也描述了完成各个活动的类。
结构图SC
-
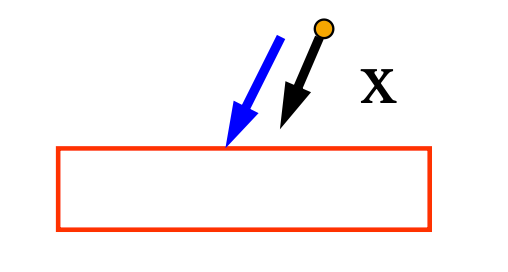
传入模块:从下层模块取得数据,经过某些处理,再将其结果传递给上级模块。
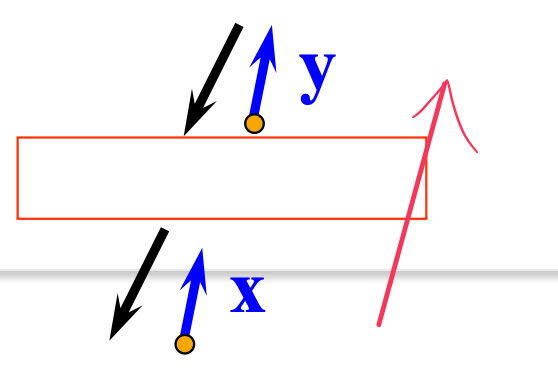
-
传出模块:从上级模块获得数据,进行某些处理,再将其结果传送给下级模块。
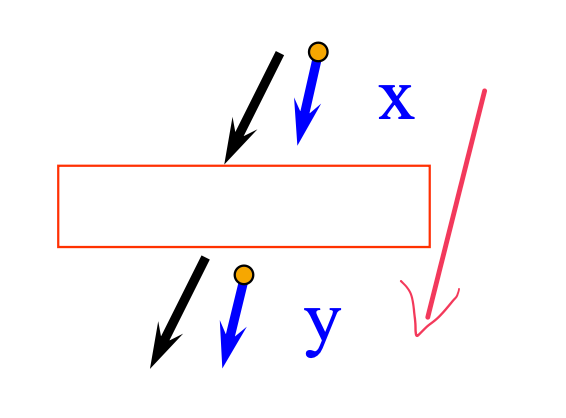
-
变换模块:从上级模块获得数据,进行特定处理,转换成其它形式,再将其结果传送给上级模块。
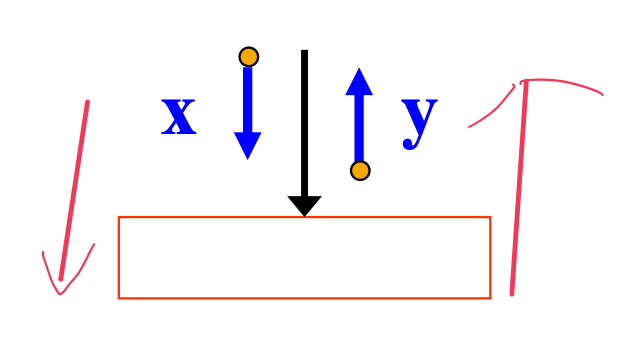
-
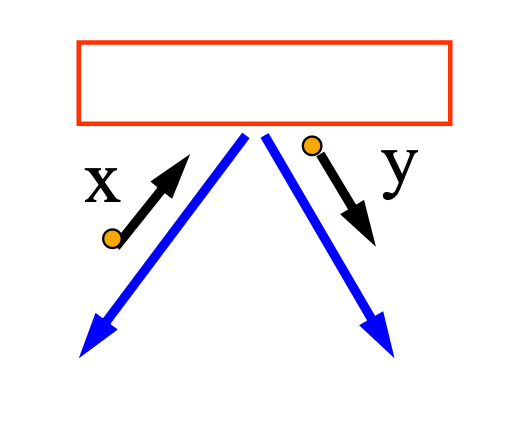
源模块:不调用其它模块的传入模块。
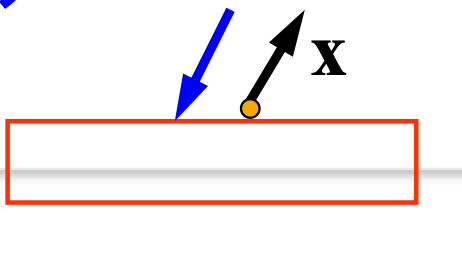
-
漏模块:不调用其它模块的传出模块。
-
协调模块:对下属模块进行控制和管理的模块。
附加符号:
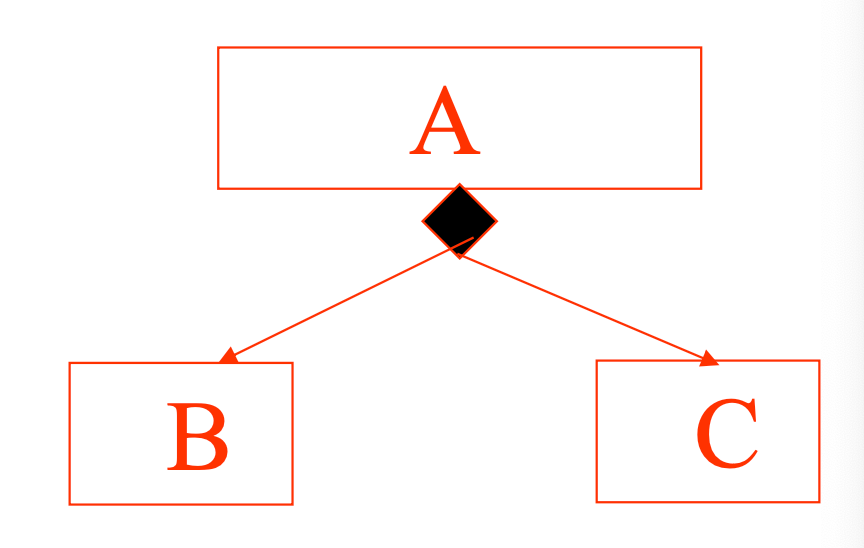
- 选择调用:
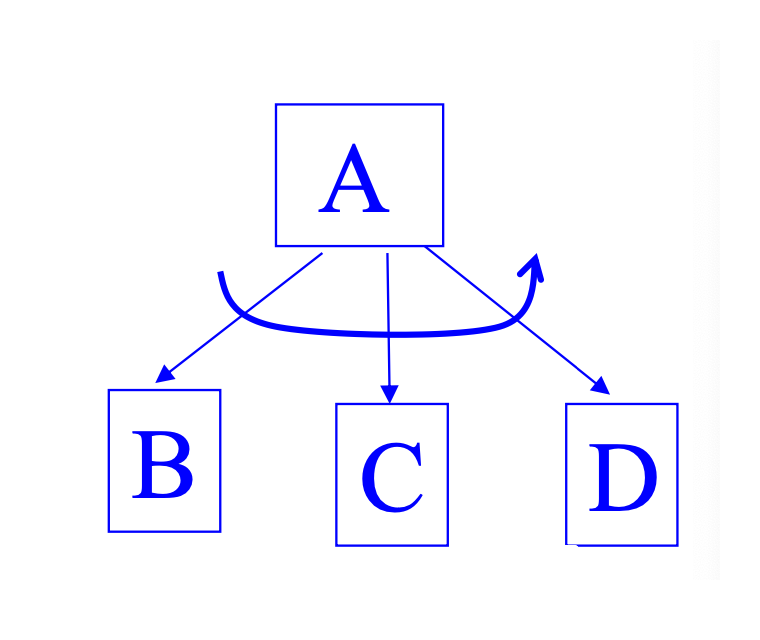
- 循环调用:
结构化设计SD
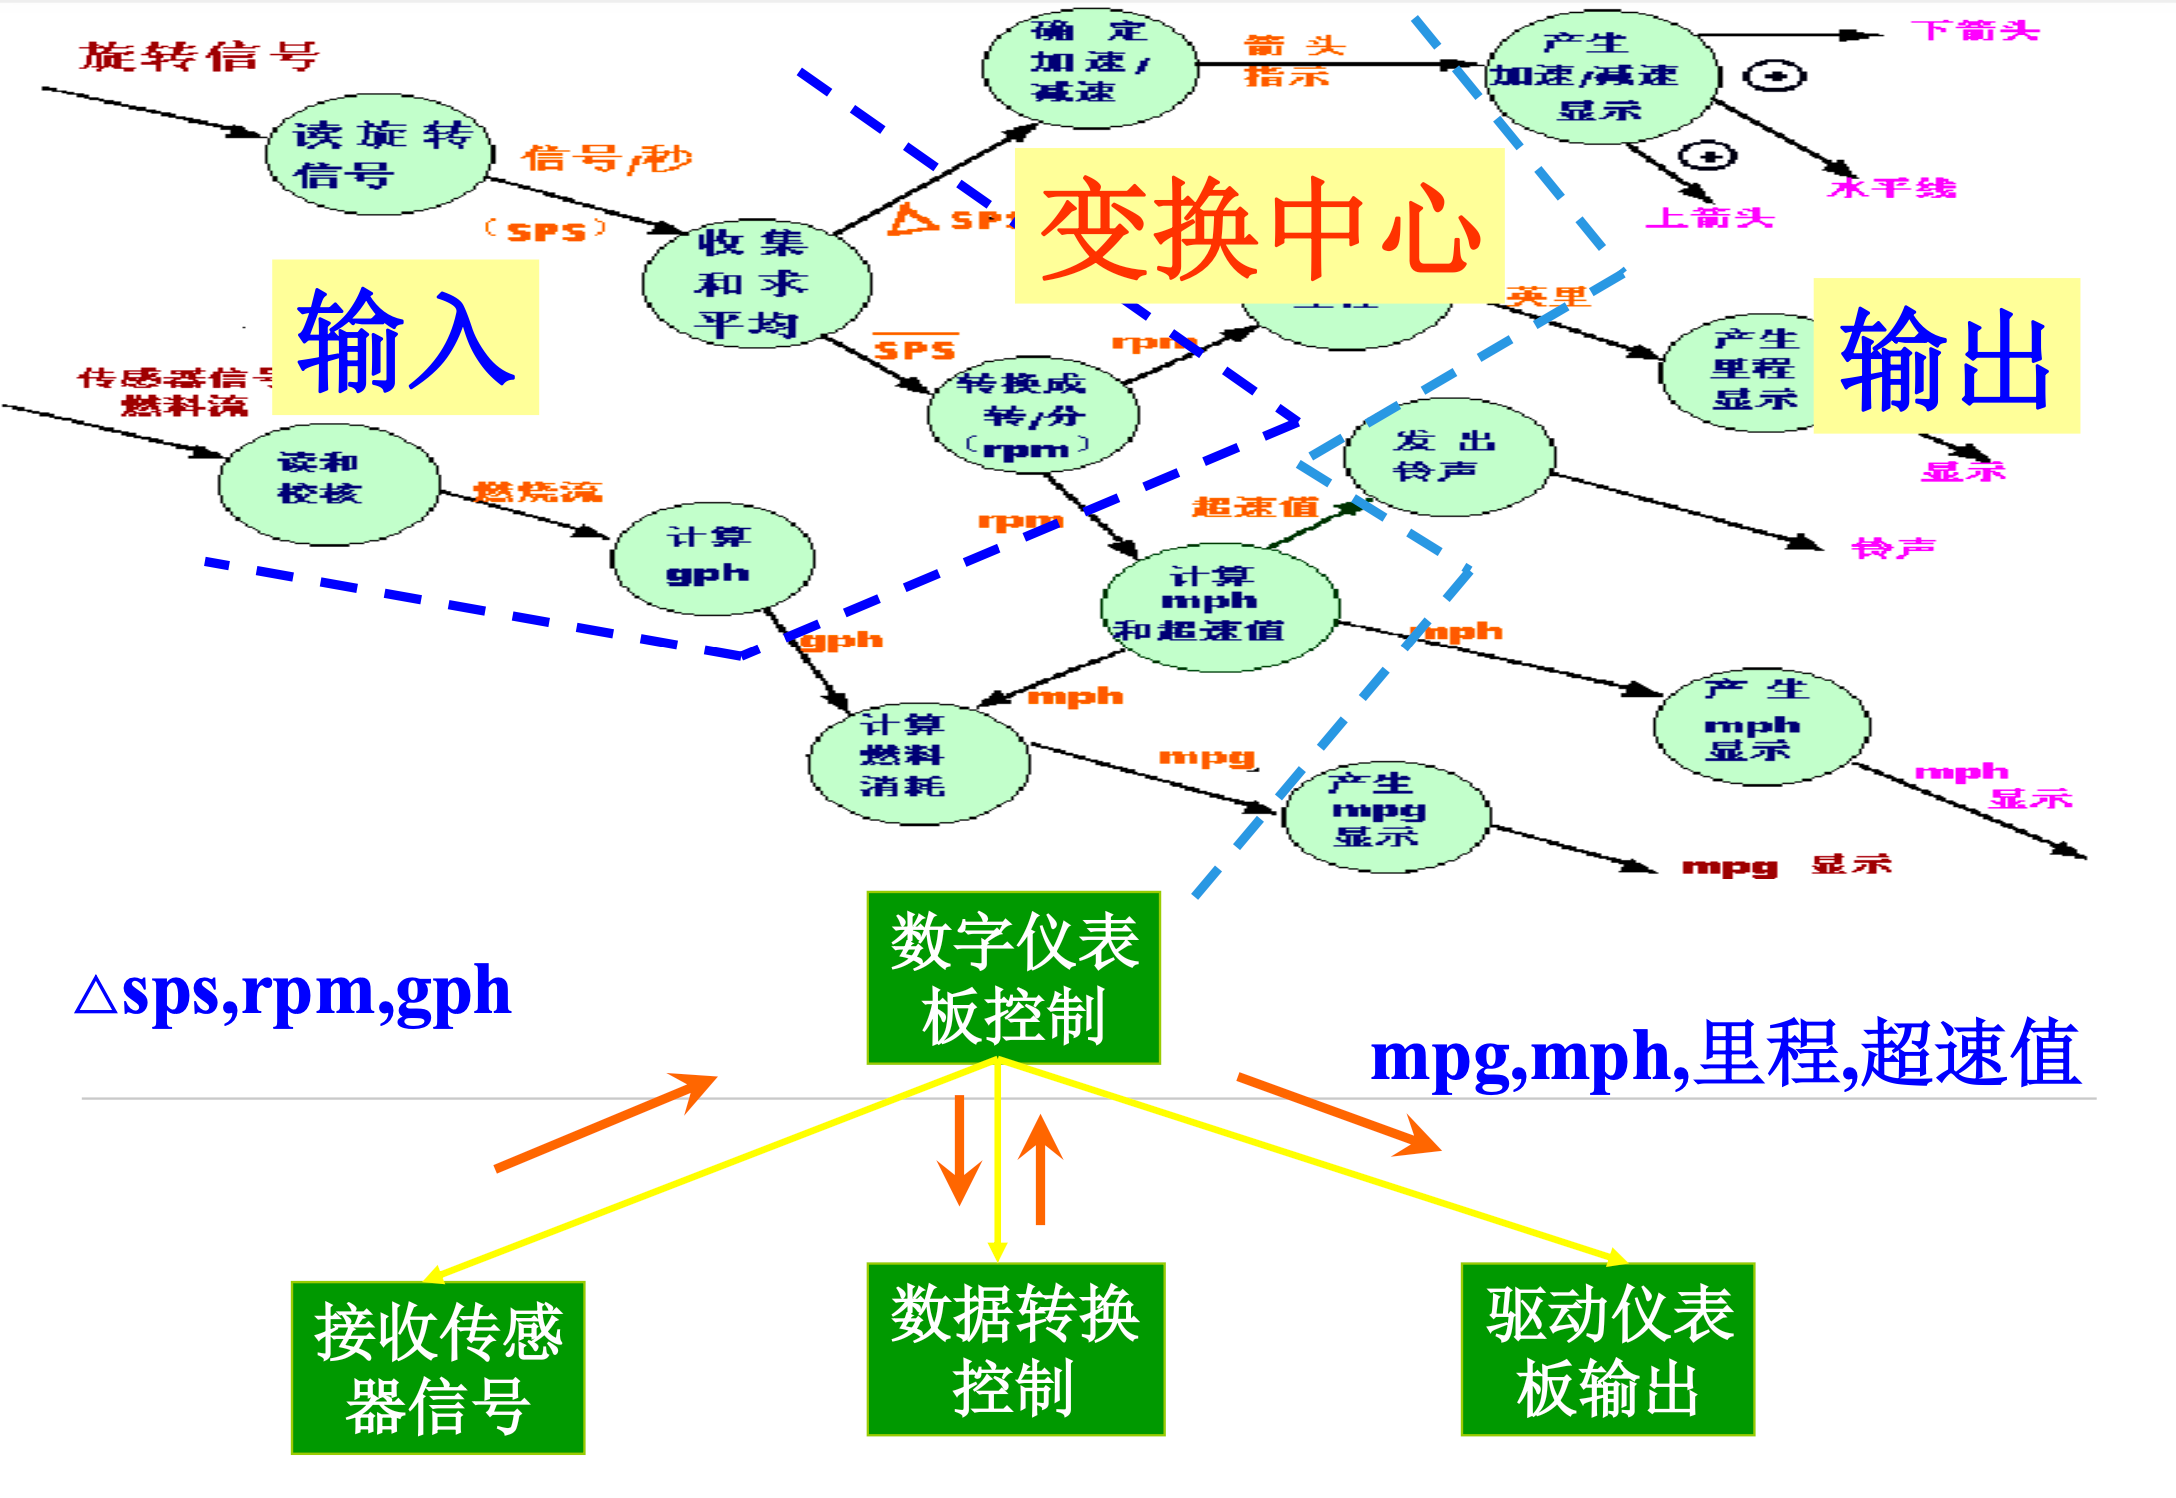
变换映射
-
识别输入边界、输出边界和变换中心三部分。
- 逻辑输入:离物理输入端(输入始端)最远,但仍可作为输入的数据流。
- 逻辑输出:离物理输出端(输出始端)最远,但仍可作为输出的数据流。
-
进行第一级分解(映射顶层和第一层)
设计主控模块和第一层软件结构:
- 输入模块ca
- 功能:为主控模块提供数据。
- 输出模块ce
- 功能:为主控模块提供数据的输出。
- 变换模块ct
- 功能:将逻辑输入转换为逻辑输出。
- 输入模块ca
-
完成“第二级和下层的映射”
- 任务:将DFD中的每一个处理映射到程序结构中的模块。
- 方法:从变换中心的边界开始,沿输入路径和输出路径向外,将处理依次映射到从属层的软件结构。
-
优化软件设计
事务映射
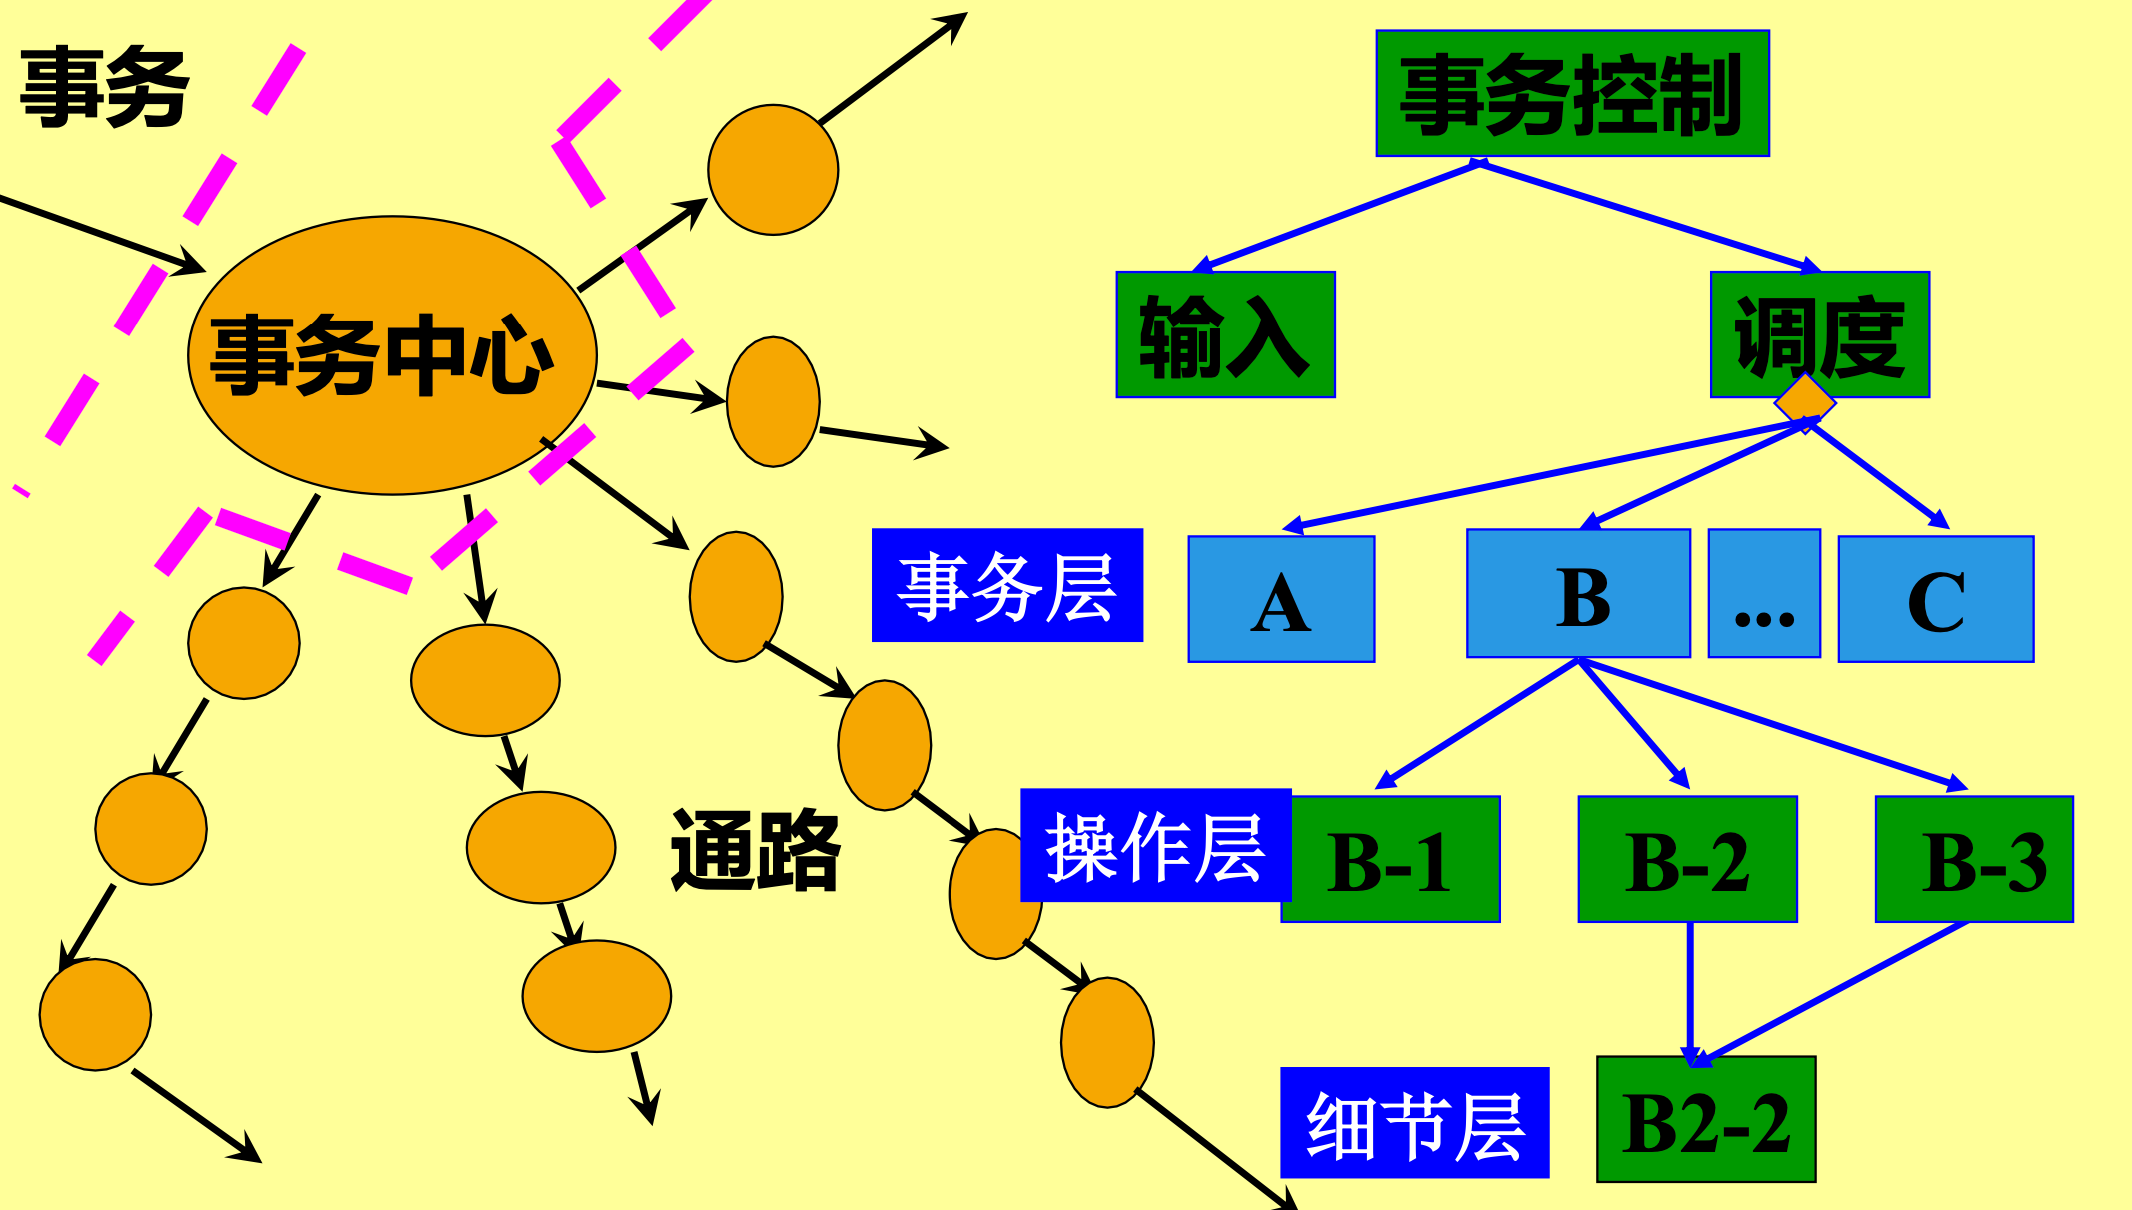
-
识别事务输入、通路和事务中心三部分。
-
进行第一级分解(映射顶层和第一层)
设计事务控制模块和第一层软件结构:
-
输入模块
- 功能:为主控模块提供数据。
-
调度模块
- 功能:根据输入的要求调度相应的执行通路。
-
-
进行第二级分解:设计中下层模块
- 方法:对通路再进行识别、划分、映射,反复此过程直到全部映射完毕。
-
优化软件设计
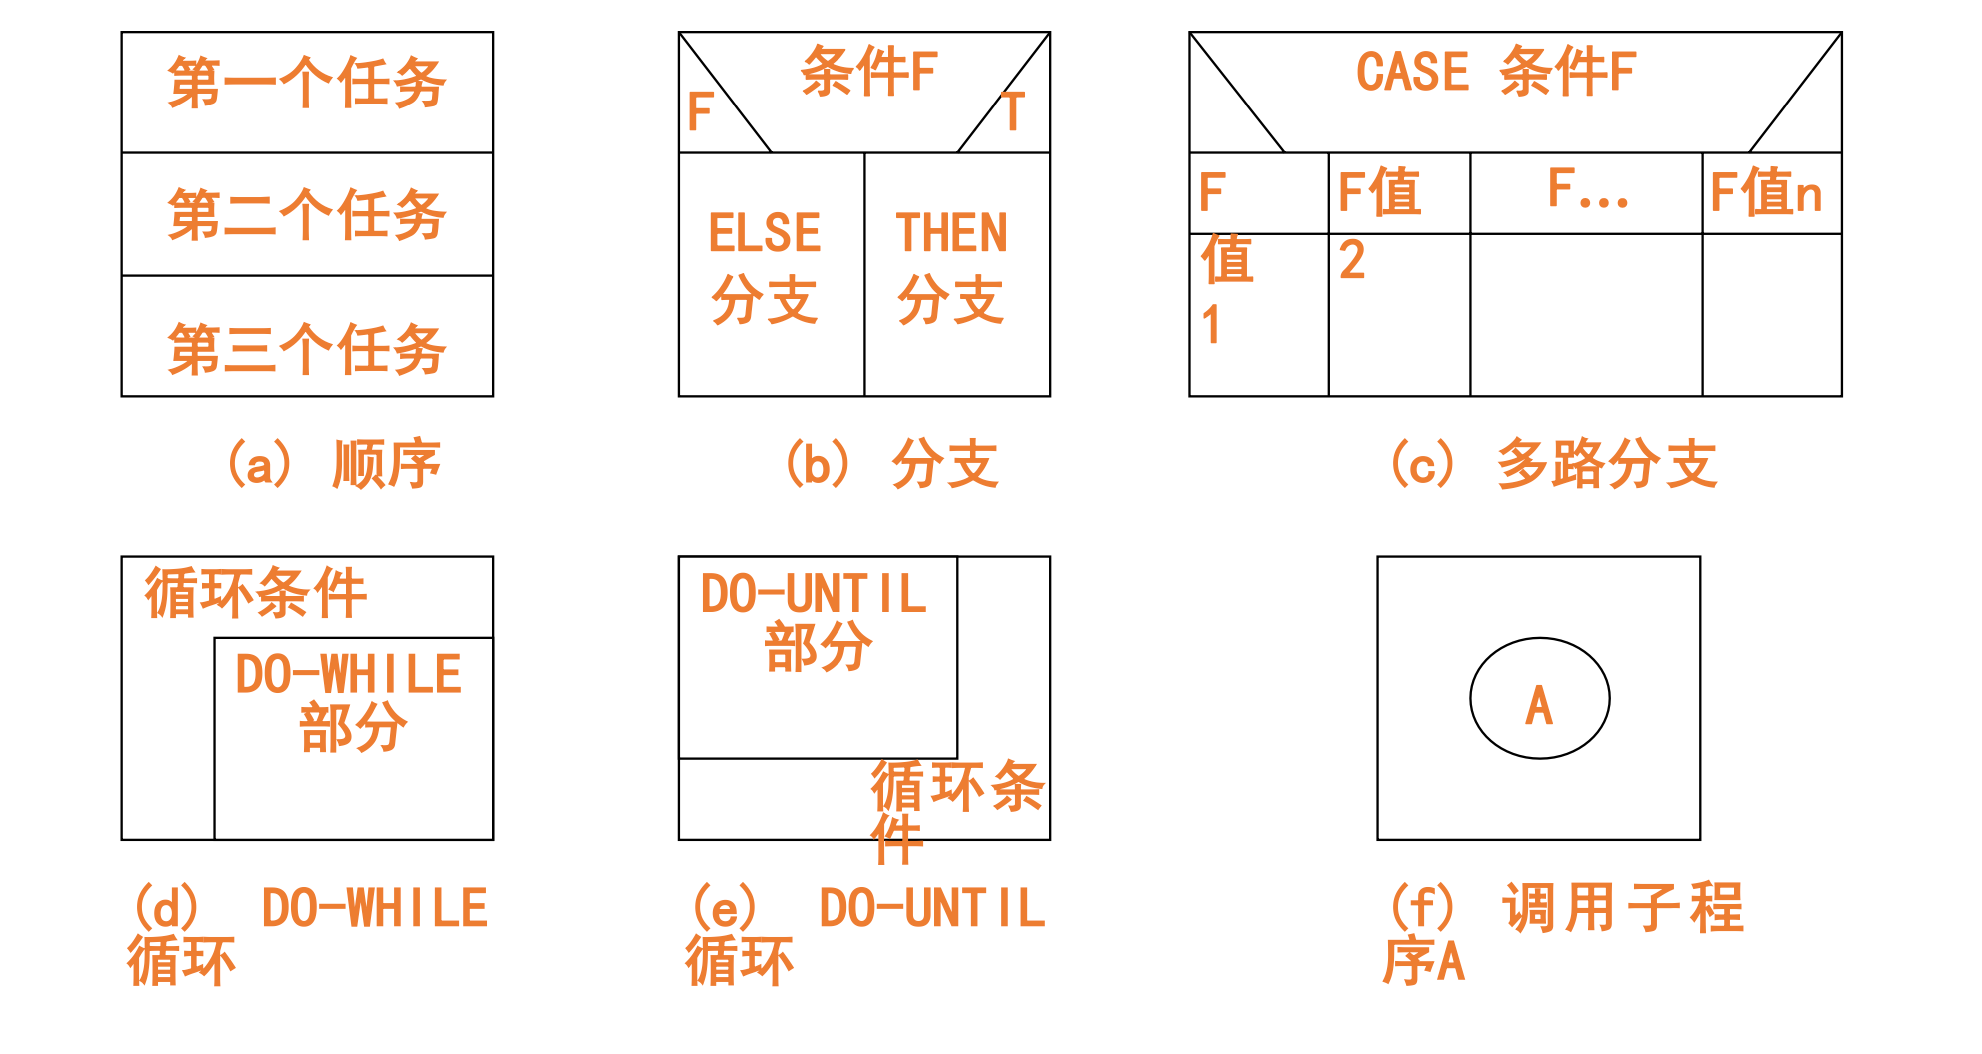
N-S图
N-S图也叫做盒图。五种基本控制结构由五种图形构件表示。
问题分析图(PAD)
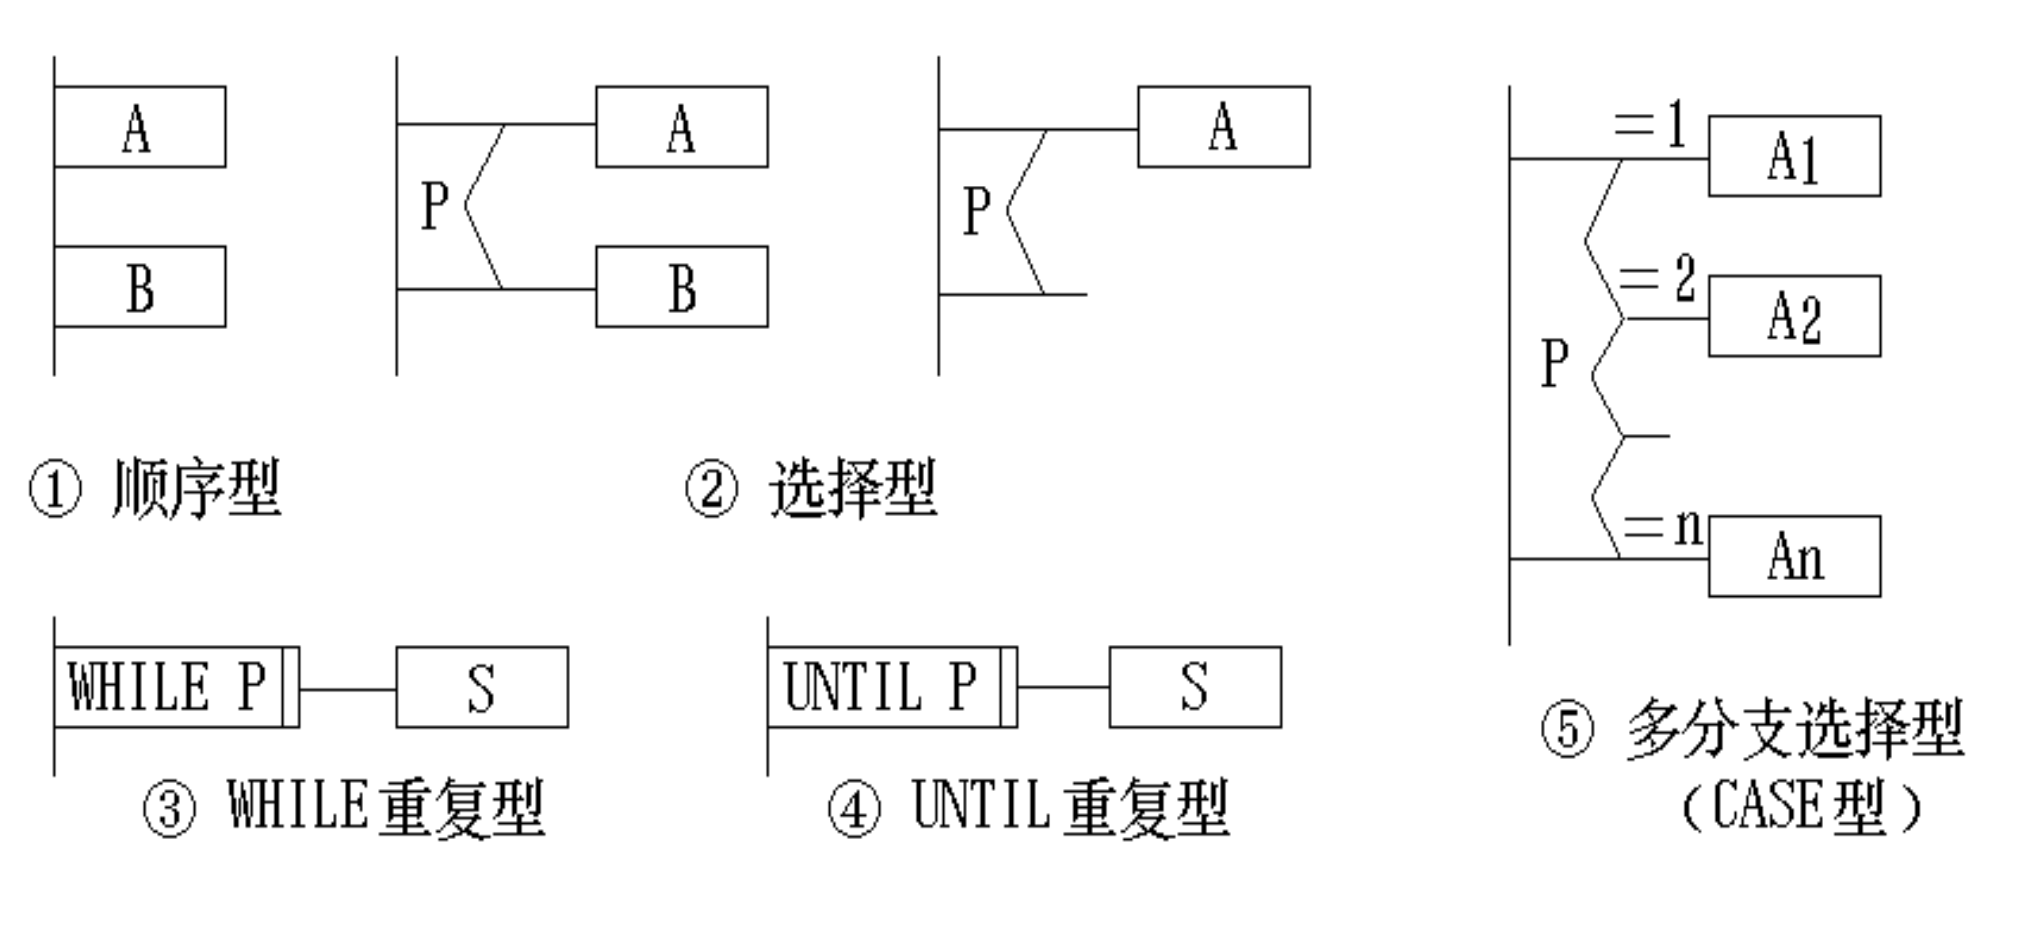
扩充控制结构:
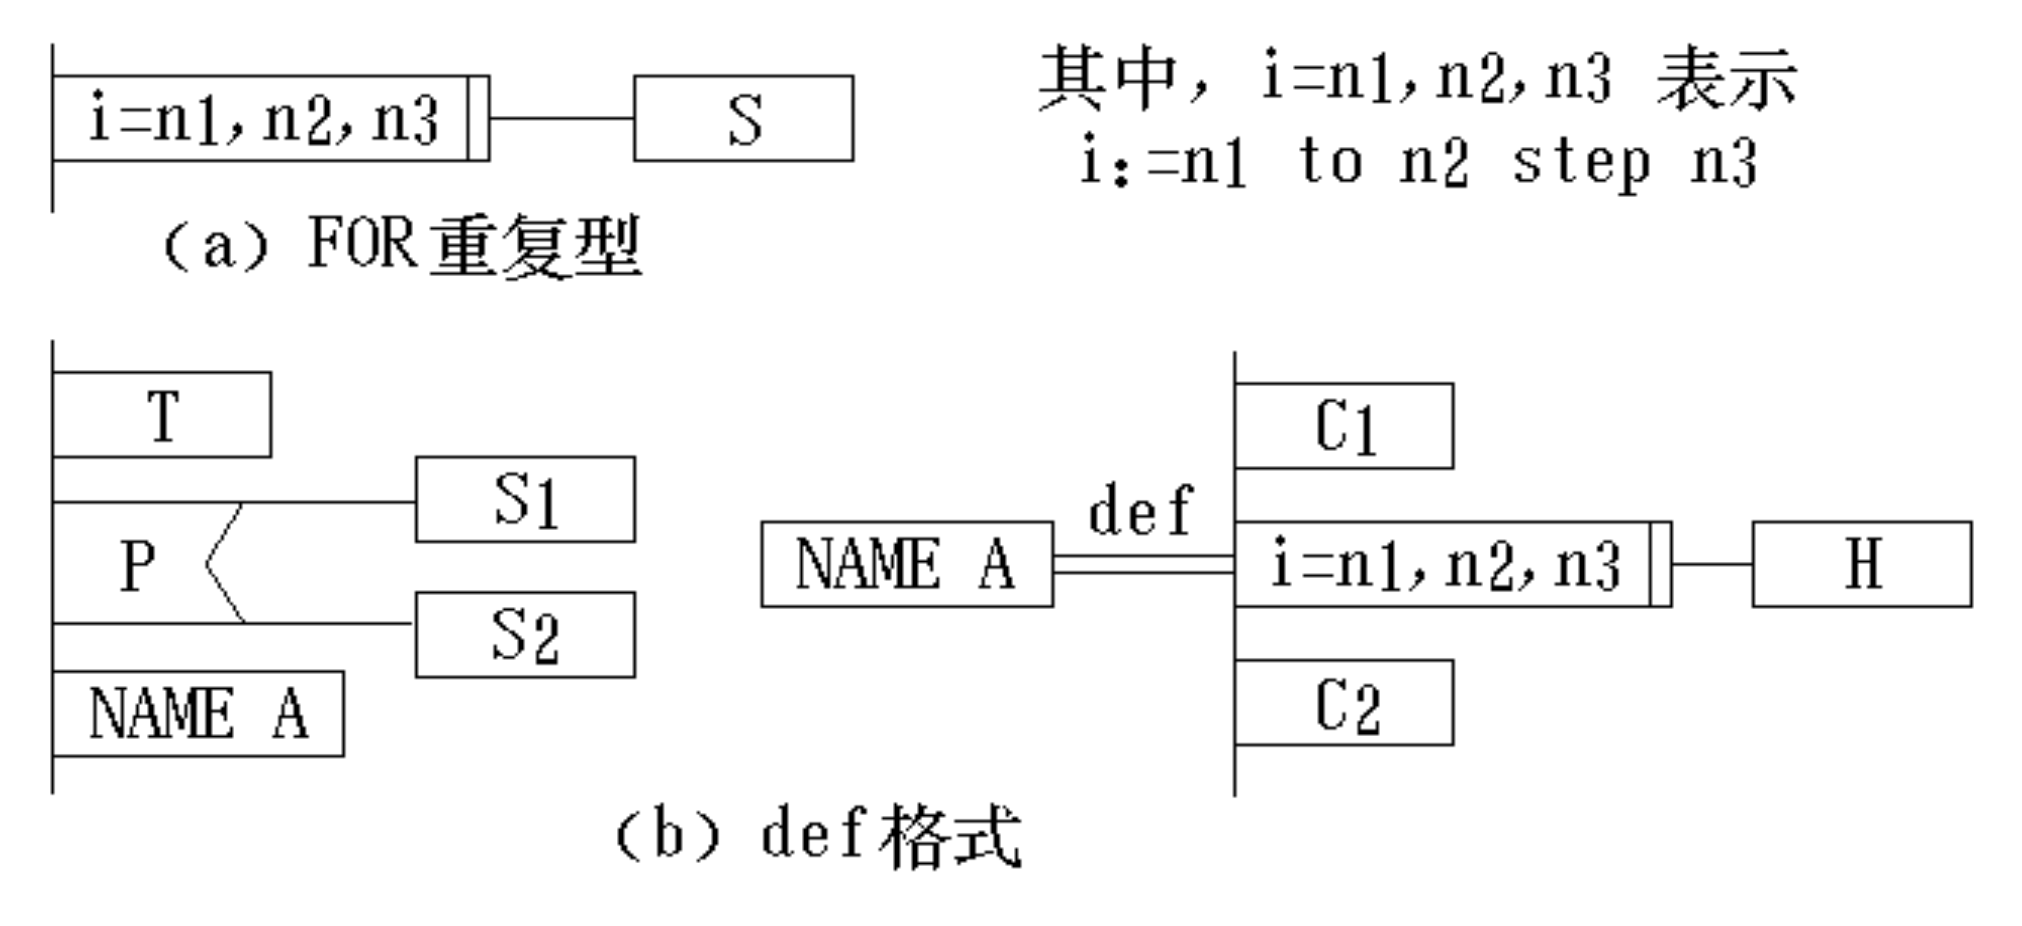
白盒测试
逻辑覆盖法
语句覆盖
将程序中每个语句至少执行一次
判定覆盖
每个判定的每个分支路径至少要执行一次。
条件覆盖
每个条件的真假两种情况至少执行一次。
条件覆盖不一定符合判定覆盖。
判定/条件覆盖
每个条件的真假两种情况至少执行一次。
每个判定的每个分支路径至少要执行一次。
条件组合覆盖
每个判定的所有条件的各种可能组合至少执行一次。
路径覆盖法
点覆盖
=语句覆盖
每个结点至少执行一次。
边覆盖
=判定覆盖
每条边至少执行一次。
路径覆盖
每个可能的路径至少执行一次。
黑盒测试
等价分类法
将所有可能的输入数据划分成若干个等价类,然后从每一类中选取少数有代表性的数据作为测试用例。
-
步骤:
- 划分等价类(有效等价类、无效等价类)
- 设计测试用例
-
设计测试用例原则:
- 有效等价类尽量选取公用测试用例,以减少测试次数。
- 无效的每类一例,以防漏掉错误。
-
选取测试用例
- 为每一个等价类规定一个唯一编号。
- 设计一个新的测试用例,使其尽可能多地覆盖尚未被覆盖的有效等价类,重复这一步,直到所有的有效等价类都被覆盖为止。
- 设计一个新的测试用例,使其仅覆盖一个尚未被覆盖的无效等价类,重复这一步,直到所有的无效等价类都被覆盖为止。
-
等价类划分的方法:
- 规定了输入条件取值范围、取值的个数,则可以确立一个有效等价类和两个无效等价类。
- 输入条件规定了输入条件输入值的集合,可确立一个有效等价类和一个无效等价类。- 有效等价类——集合内 - 无效等价类——集合外
- 如果输入条件是一个布尔量,则可以确定一个有效等价类和一个无效等价类。
- 如果规定了输入数据的一组值,而且程序要对每个输入值分别进行处理:- 每一个输入值——一个有效等价类 - 所有不允许的输入值的集合——一个无效等价类
- 如果规定了输入数据必须遵守的规则,则可以确立一个有效等价类(符合规则)和若干个无效等价类(从不同角度违反规则)。
边界值分析法
对等价分类法的补充:
- 针对各种边界情况设计测试用例。
- 大量的错误是发生在输入/输出范围的边界上,而不是在输入范围的内部。
步骤:
- 首先应确定边界情况。
- 选取正好等于、刚刚大于、刚刚小于边界的值作为测试数据。
错误推测法
人们也可以靠经验和直觉推测程序中可能存在的各种错误,从而有针对性地编写检查这些错误的测试用例——错误推测法。